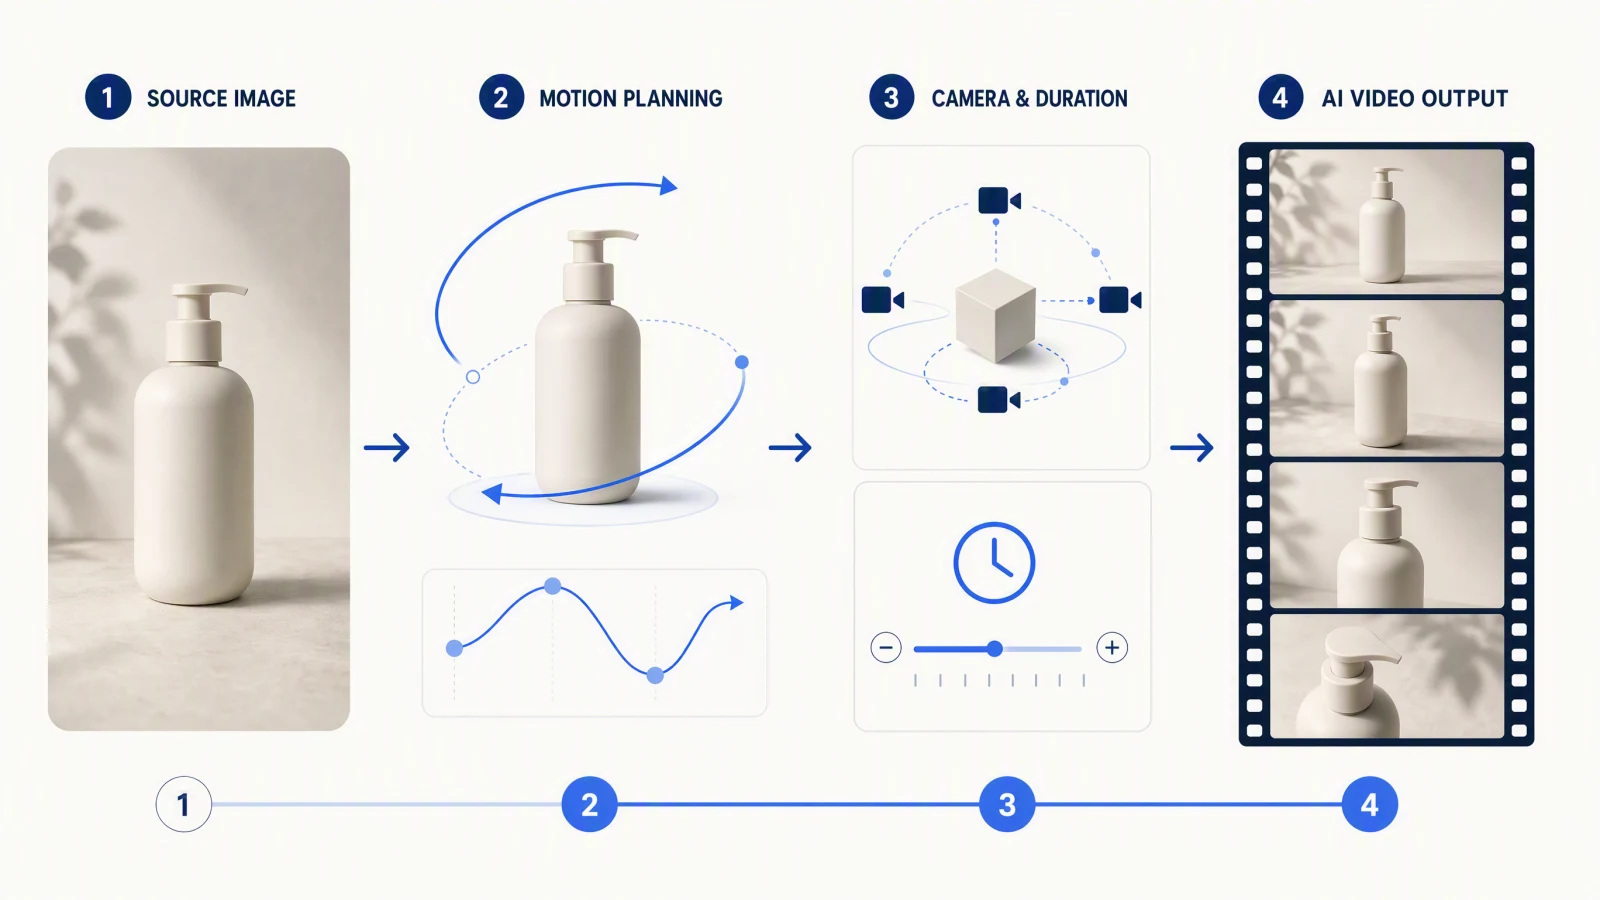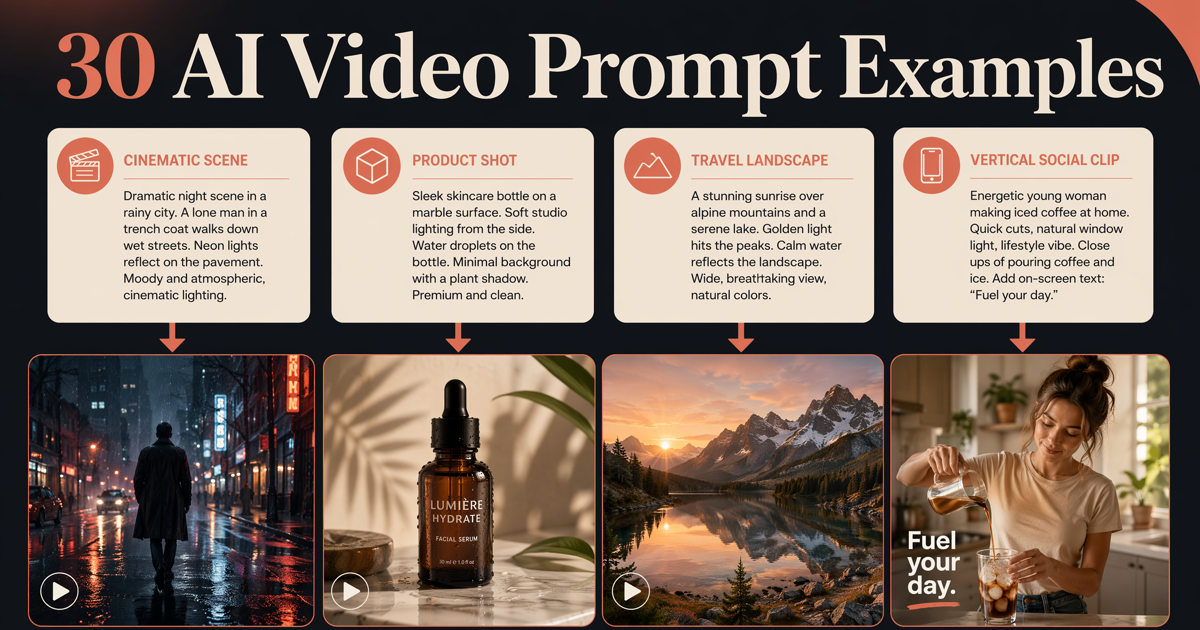
Seedance 2.5 提示词大全:24 条可复制提示词 + 12 个 30 秒案例
把 Seedance 2.5 提示词当成一份简短的导演笔记。先写主体,再写动作、镜头、时间、声音、参考素材分工和不能改变的细节。30 秒视频可以拆成吸引、展开、证明和收尾四段,让结尾从一开始就有位置。写之前先选模式:没有素材用文生视频,需要保留外观时用图生视频,需要控制开头和结尾时用首尾帧,多份素材各有用途时再用参考生视频。下面 12 个原创案例都是可改写模板。请把通用产品、人物、场景和声音换成你有权使用的素材,再生成基准版,一次只改一个变量。12 个案例下方都附上了我们用同一条提示词实际生成的 Seedance 2.5 画面、所用参数,以及模型没有照做的地方。
要点速览
- 按这个顺序写:主体 -> 动作 -> 镜头 -> 时间 -> 声音 -> 参考素材分工 -> 约束。
- 30 秒内容可先按吸引、展开、证明、收尾四段规划。
- 先选文生、图生、首尾帧或参考生视频,再增加细节。
- 每份参考素材只负责一项主要任务,避免身份、风格和场景互相污染。
- 完整看完基准版后,一次只修改一个字段。
- 12 条完整提示词我们都按 4 秒、480p 实测过:模型基本只演前一两段,结尾常被丢掉,所以「时间」一行要按实际生成时长来写。
快速答案
一条容易检查的 Seedance 2.5 提示词,应该写明一个主体、一个可见动作、一种主运镜、分段时间、声音方向、每份参考素材的职责,以及必须保持不变的内容。30 秒可先用 0-5 秒吸引、5-16 秒展开、16-25 秒证明或升级、25-30 秒收尾。这只是内容规划工具,不代表模型会按帧精确执行。先选择能保留关键内容的最简单模式,只有当每份素材都有明确职责时才增加参考。想看完整案例实际跑出来是什么样,可以直接看我们如何实测这 12 个案例和三次只改一行的前后对比。
更新并核验于 2026 年 10 月 13 日:12 个完整案例均用 Seedance 2.5 实测生成,并对照 SeedVideo AI 网页生成器、Seedance 2.5 模型页与模型文档。
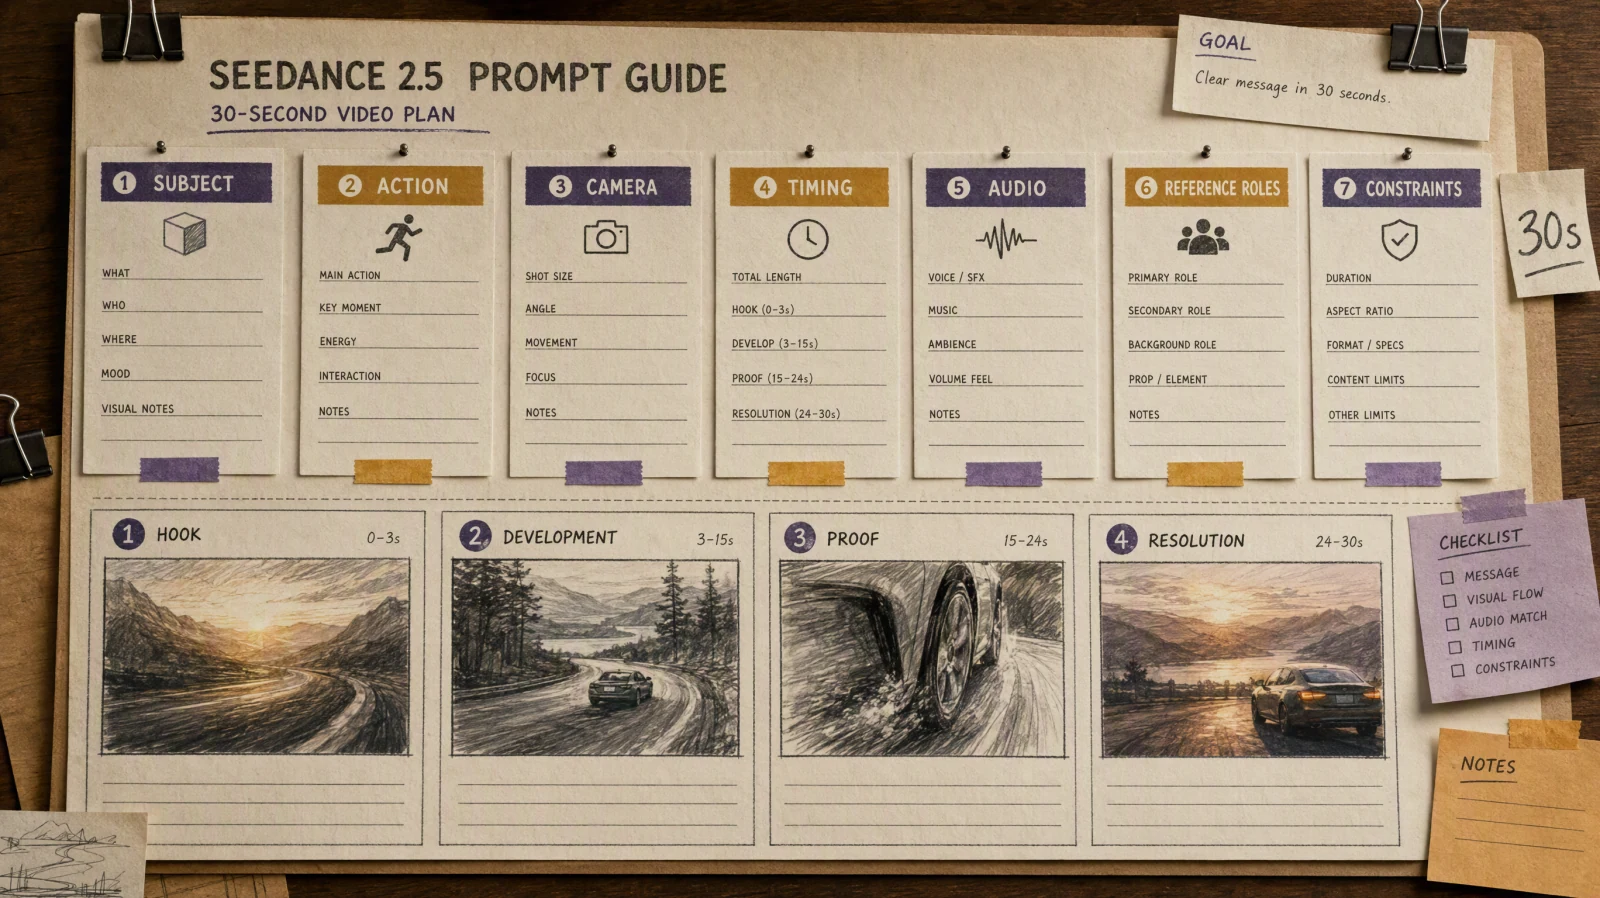
30 秒提示词可以按七个字段写成可检查的导演简报。
Seedance 2.5 提示词的七个字段
主体:谁或什么必须保持可辨认?
动作:画面里会发生什么变化?
镜头:景别和运镜如何带领观众?
时间:每一段发生什么,最后如何收尾?
声音:对话、环境音、节奏或安静如何配合动作?
参考素材分工:哪份素材负责身份、产品、环境、动作、风格或声音?
约束:哪些细节不能变,哪些内容不应出现?
具体名词和动词比一串形容词更容易检查。“陶瓷杯旋转一周,镜头从中景缓慢推到特写”比“高级、震撼、电影感的产品展示”更容易判断成败。
需要通用公式和短案例时,可以看 Seedance 提示词指南。需要平移、推进、环绕和跟拍词汇时,可以看 AI 视频镜头运动提示词。
不同模式应该重点写什么
| 模式 | 起点素材 | 重点字段 | 参考写法 | 先检查 |
|---|---|---|---|---|
| 文生视频 | 一段场景说明 | 主体、动作、镜头、时间 | 不需要素材标记 | 场景和动作是否读得懂 |
| 图生视频 | 一张有权使用的图片 | 动作、镜头、固定外观 | 说明源图必须保留什么 | 身份、几何形状和意外变形 |
| 首尾帧 | 两张可衔接图片 | 过渡路径、时间、结尾 | 分开指定开头与结尾构图 | 动作是否自然连接两帧 |
| 参考生视频 | 各有职责的图片、视频或音频 | 素材分工、约束、时间 | SeedVideo AI 当前文档中,@image1、@video1、@audio1 按数组顺序对应 | 每份素材是否只影响自己的职责 |
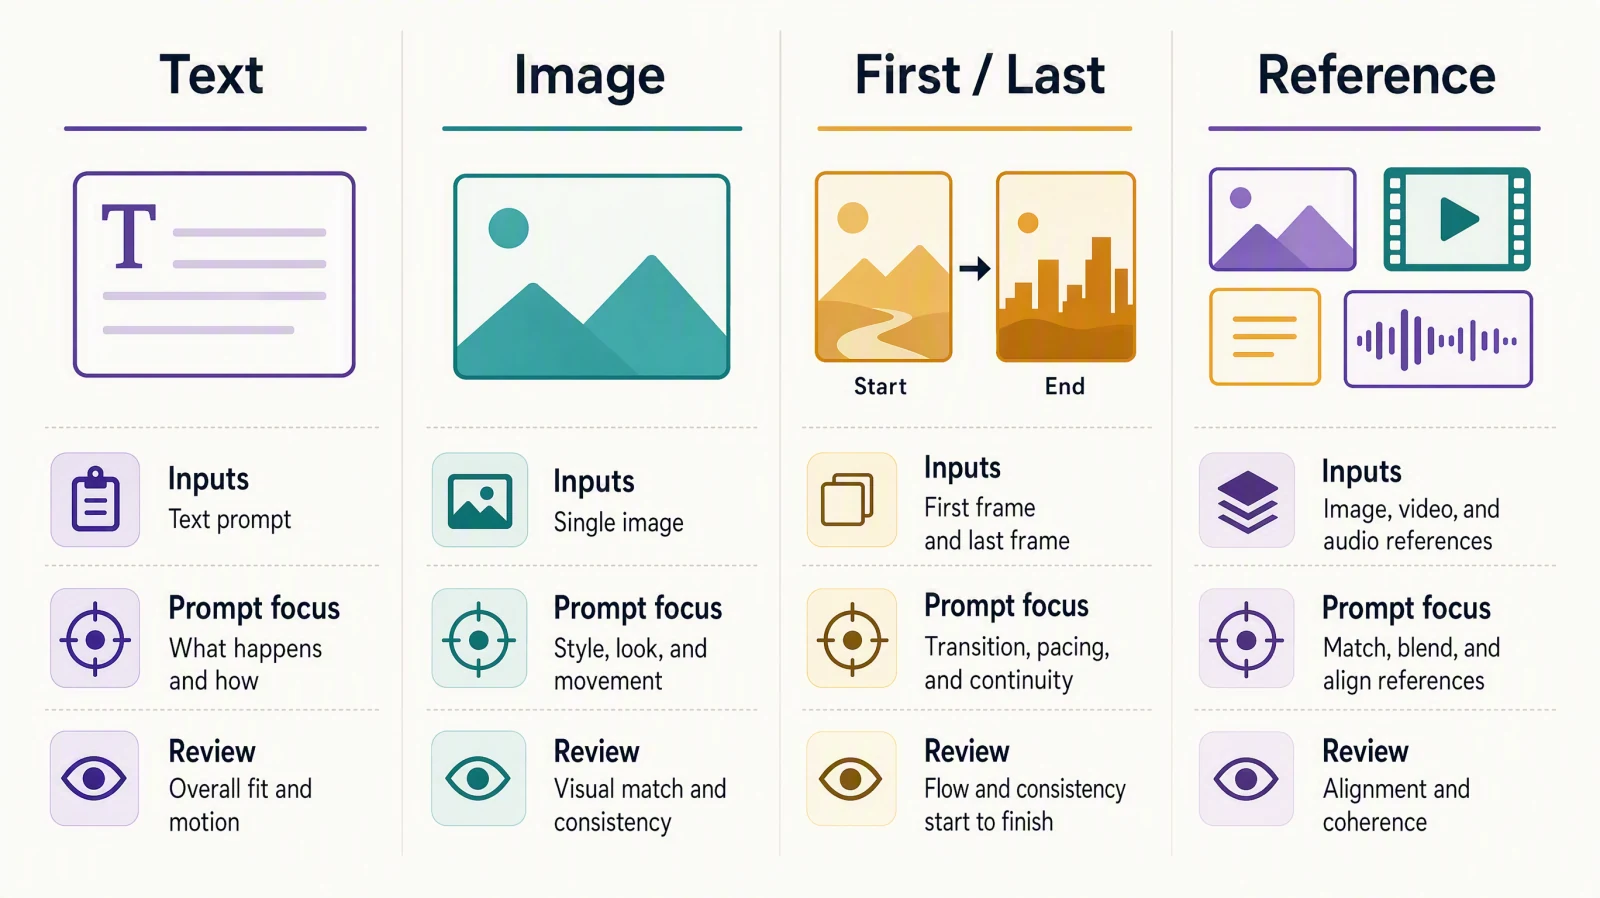
先选模式,再把篇幅用在该模式最需要的字段上。
上面的参考标记来自 SeedVideo AI 模型文档,核验日期为 2026 年 8 月 2 日。Dreamina 有自己的界面和素材命名方式,不要把一个产品的标记原样搬到另一个产品。粘贴提示词前,先确认当前页面真实显示的模式和字段。
Seedance 2.5 参数速查表
提示词只是一半,另一半是设置面板,而且网页生成器和公开 API 的限制不同。下表是 2026 年 10 月 11 日两个入口分别暴露的参数。
| 设置 | SeedVideo AI 网页生成器 | SeedVideo AI API |
|---|---|---|
| 时长 | 4–30 秒(默认 5 秒) | 4–30 秒 |
| 分辨率 | 480p / 720p / 1080p;1080p 需要 Pro、Premium 或积分包,Lite 最高 720p | 480p 或 720p |
| 草稿模式 | 先出 480p 预览,再把满意的那条升级到 1080p;草稿按 480p 计费 | 不提供 |
| 画幅 | 16:9、9:16、1:1、4:3、3:4、21:9、自适应 | 相同 |
| 音频 | 默认开启,可关闭 | generate_audio |
| 参考素材 | 最多 9 张参考图 + 1 段参考视频(2–15 秒) | 最多 30 张图、10 段视频、10 段音频,按顺序用 @image1、@video1、@audio1 引用 |
| 提示词长度 | 最多 2,500 字符 | 最多 2,500 字符 |
| 积分 | 480p 约 3 积分/秒、720p 约 6、1080p 约 15(积分包基准价,订阅用户单价更低) | 相同,见价格页 |
提示词该写多长取决于你选的时长。下面是我们写稿时的经验值,不是模型限制:
| 时长 | 节拍 | 便于复查的提示词长度 | 失败时先删什么 |
|---|---|---|---|
| 4–5 秒 | 1 个镜头、1 个动作 | 40–80 词 | 次要动作和风格形容词 |
| 10 秒 | 1–2 拍 | 60–120 词 | 第二个运镜 |
| 15 秒 | 2–3 拍 | 90–160 词 | 对白,只留环境音 |
| 30 秒 | 4 拍(开场、推进、证明、收尾) | 150–260 词 | 第三、四拍的细节,保住结尾 |
核验日期:2026 年 10 月 11 日,依据 SeedVideo AI 网页生成器、Seedance 2.5 模型页与模型文档。
如何规划 30 秒场景
| 段落 | 规划时间 | 任务 | 写之前问什么 |
|---|---|---|---|
| 吸引 | 0-5 秒 | 建立主体和继续观看的理由 | 什么会立即变化? |
| 展开 | 5-16 秒 | 展示主要动作或问题 | 观众需要明白什么? |
| 证明 | 16-25 秒 | 让结果、后果或转折可见 | 哪个画面能证明前面的内容? |
| 收尾 | 25-30 秒 | 留下稳定结尾或呼应 | 最后一帧应该说明什么? |
这些时间是写作辅助,不是精确剪辑点。产品演示可能需要更长的“证明”,对话场景则可能把更多时间留给“展开”。
我们如何实测这 12 个案例
2026 年 10 月 13 日,我们把下面 12 个完整案例的提示词各用 Seedance 2.5 生成了一次,提示词与本文英文版逐字一致。所有生成都用模型允许的最短设置:4 秒、480p。这只是每条提示词所规划的 30 秒中的一小段,所以画面能说明模型先演哪几段、人物、产品和参考素材保持得怎样;要判断 30 秒成片的结尾,仍然需要完整时长生成。
- 参数: Seedance 2.5,480p,4 秒,每条生成一次。文生视频按提示词里的画幅;图生视频以源图作首帧、画幅自适应;参考生视频使用案例列出的
@image、@video、@audio素材。 - 声音: 对话、口播、音乐和 UGC 案例(5、7、10、11、12)开启音频,其余关闭。下面的记录只描述画面,台词和音乐没有逐一人工听辨。
- 输入素材: 所有人物、产品图、房间、服装板和风格帧都是 AI 生成的替身素材。动作参考是 AI 生成的短视频,替代提示词里说的自拍素材;对话和口播音轨是合成语音,音乐是原创合成的循环片段。
- 生成耗时: 每条从提交到出片的实际时间。你的等待时间会随排队情况和参数变化。
| # | 案例 | 模式与输入 | 耗时(分:秒) | 最大偏差 |
|---|---|---|---|---|
| 1 | 桌面台灯产品故事 | 文生,16:9 | 2:22 | 跳过了画草图 |
| 2 | 雨夜站台 | 文生,16:9 | 2:36 | 停在火车驶过,没拍到人物决定 |
| 3 | 竖屏柑橘拌面 | 文生,9:16 | 2:24 | 没用成品碗开场,面条变色 |
| 4 | 护肤品瓶身微距 | 图生(首帧) | 4:56 | 水滴落在标签正面而不是瓶侧 |
| 5 | 从人像到对话 | 图生(首帧),开音频 | 5:30 | 画面上没有明显偏差 |
| 6 | 原创插画动起来 | 图生(首帧) | 5:09 | 两盏灯同时亮起,钟针没动 |
| 7 | AI UGC 产品演示 | 参考:2 图 + 1 视频,9:16 | 4:52 | 多出第二个容器 |
| 8 | 从预演到成片 | 参考:2 图 + 1 视频,16:9 | 5:17 | A、B 走位互换 |
| 9 | 产品、环境和风格分工 | 参考:3 图 + 1 视频,16:9 | 4:41 | 厨房布局变了,玻璃壶来自动作视频 |
| 10 | 双人对话 | 参考:2 图 + 1 音频,16:9 | 4:07 | 没回到宽景 |
| 11 | 音乐节奏几何动画 | 参考:1 图 + 1 音频,1:1 | 4:51 | 看不到停顿,结尾不平衡 |
| 12 | 声音为主的竖屏口播 | 参考:1 图 + 1 音频,9:16 | 3:49 | 没有指向手势,空白纸上多了图形 |
每个案例末尾都有一段「实测结果」和生成结果本身:完整 4 秒片段,静音循环播放。案例 3、7、8 还各做了一次只改一行的修改,见三次只改一行的前后对比。
文生视频案例
1. 桌面台灯的产品故事
适合: 没有源图,先测试横屏产品概念。
输入: 纯文本,16:9。
提示词: 主体是一间小型公寓工作室里的无品牌哑光白色台灯。房间开始很暗,设计师打开台灯、调整灯臂、完成草图,再把草图钉到墙上。用广角固定镜头开场,调整灯臂时做一次缓慢横移,最后停在产品特写。0-4 秒展示暗房,4-15 秒开灯和调整,15-25 秒展示绘图进度,25-30 秒保持完整台灯,草图在背景虚化。声音只保留开关、铅笔和室内环境音。只出现一个人和一盏灯,不要品牌、画面文字和多余运镜。
为什么这样写: 产品有明确用途,结尾也有稳定画面。
需要检查: 台灯形状、手部交互、镜头路径和结尾稳定性。
实测结果(Seedance 2.5,文生视频,16:9,480p,4 秒,关闭音频,生成耗时 2 分 22 秒): 暗房里台灯亮起,设计师调整灯臂,开场和准备两段都拍到了。没按提示词走: 跳过了画草图这一段,直接跳到钉在墙上的草图和灯臂特写;前景还有一只虚化的手划过,而提示词要的是稳定的产品画面。
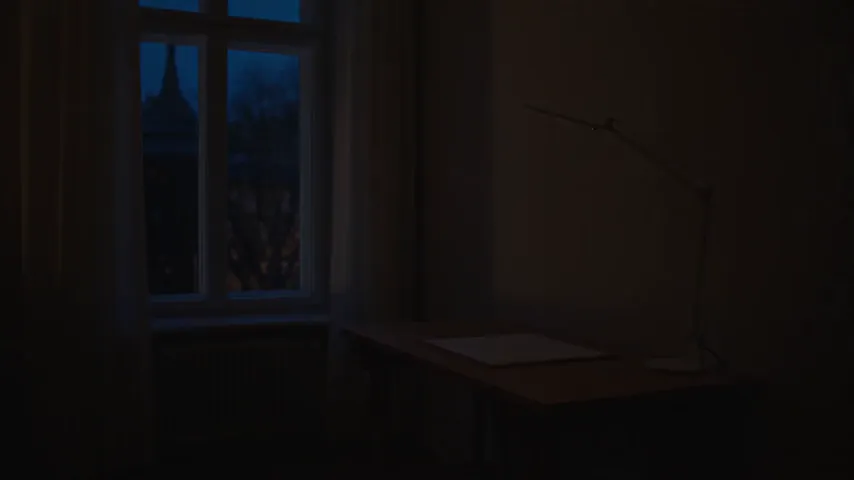
案例 1 实测,完整 4 秒片段(循环播放):先调灯臂,然后直接跳到钉好的草图。
2. 雨夜站台的电影镜头
适合: 测试单人物短片的气氛和情绪转折。
输入: 纯文本,2.39:1 或 16:9。
提示词: 一名穿深色素面外套的成年旅客,在黄昏的乡村站台独自等车。旅客查看旧纸车票,听到火车靠近,最后决定不上车并收起车票。用克制的手持中景,缓慢推向车票,火车经过时切到侧面全景,再回到稳定特写。0-6 秒建立站台,6-15 秒展示车票和远处灯光,15-24 秒让火车经过,24-30 秒保留人物决定后的表情。声音只有雨、轨道和火车。只出现一名旅客,外套和灯光保持一致。
为什么这样写: 动作有起点、选择和结果,镜头变化也跟着人物决定走。
需要检查: 人物身份、火车方向、车票连续性和意外路人。
实测结果(Seedance 2.5,文生视频,16:9,480p,4 秒,关闭音频,生成耗时 2 分 36 秒): 黄昏站台、雨、查看车票和驶过的火车都有,外套和站台灯光前后一致。没按提示词走: 片子停在火车驶过,“决定不上车、收起车票”和最后的静止特写都没出现;纸车票上还多了半可读的印刷字。
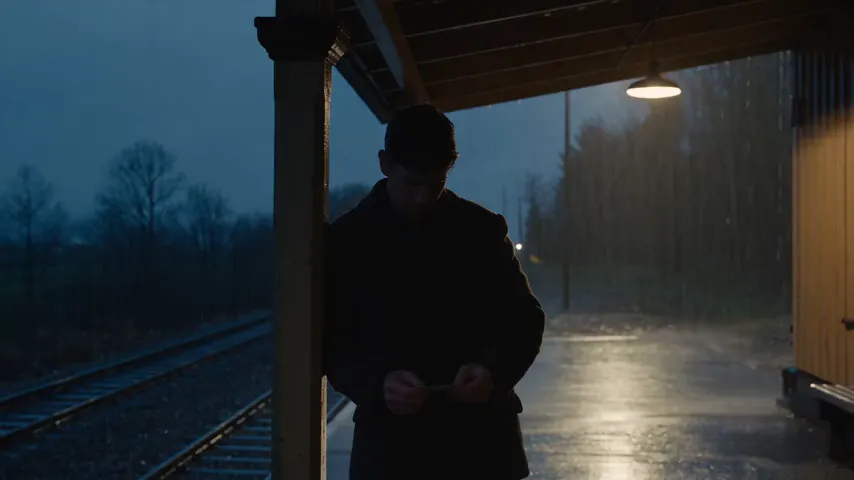
案例 2 实测,完整 4 秒片段(循环播放):车票特写,片子停在火车驶过。
3. 竖屏柑橘拌面短视频
适合: 用快速视觉结果吸引观众的 9:16 社交内容。
输入: 纯文本,9:16。
提示词: 家庭厨房里制作一碗无品牌柑橘拌面。先用顶拍展示成品,再切回备料、拌面和装盘,最后夹起一口带蒸汽的面。0-3 秒展示成品,3-13 秒备料,13-23 秒拌面和质感,23-30 秒装盘与夹面。声音只有清晰厨房声和轻微节奏,不要口播或生成字幕。只用一个碗,食材颜色保持一致,安全使用厨具,不要标签和不合理食物变形。
为什么这样写: 开头立即给出结果,镜头都围绕手机小屏能看清的动作。
需要检查: 食物连续性、手部结构、开头与结尾的碗是否一致。
实测结果(Seedance 2.5,文生视频,9:16,480p,4 秒,关闭音频,生成耗时 2 分 24 秒): 厨房干净、只有一个碗,结尾也夹起了一口面。没按提示词走: 开场是没拌的面和胡萝卜、香菜等生料,而不是成品碗;没有拌面动作;到尾帧面条变成了橙色,筷子上还多了一块橙子,违反“食材颜色保持一致”。只把「时间」一行按 4 秒重写,开场和颜色就都修好了,两版对比见修改 1。
图生视频案例
4. 护肤品瓶身微距展示
适合: 用一张已授权产品图固定外观,再增加少量动作。
输入: 一张中性背景的自有产品图,16:9。
提示词: 保留源图的瓶身形状、瓶盖、标签位置、颜色和比例。瓶身慢慢出现水汽,一滴水沿侧面滑落,叶片阴影缓慢掠过背景。镜头从中近景做一次缓慢微距推进,最后回到完整瓶身。0-5 秒展示质感,5-18 秒推进和阴影,18-25 秒水滴滑到底部,25-30 秒保持完整产品。不要改变标签文字、移动瓶盖、复制瓶身、增加卖点或漂浮粒子。
为什么这样写: 动作只限于水汽、阴影和镜头,源图职责明确。
需要检查: 瓶身几何形状、标签位置和任何新增宣传词。
实测结果(Seedance 2.5,图生视频,源图作首帧,画幅自适应,480p,4 秒,关闭音频,生成耗时 4 分 56 秒): 12 条里最贴合的一条。瓶型、瓶盖和“SERUM”标签全程一致,有缓慢推近,也出现了水汽。没按提示词走: 水滴落在标签正面而不是瓶身侧面,叶影到后半段才出现。
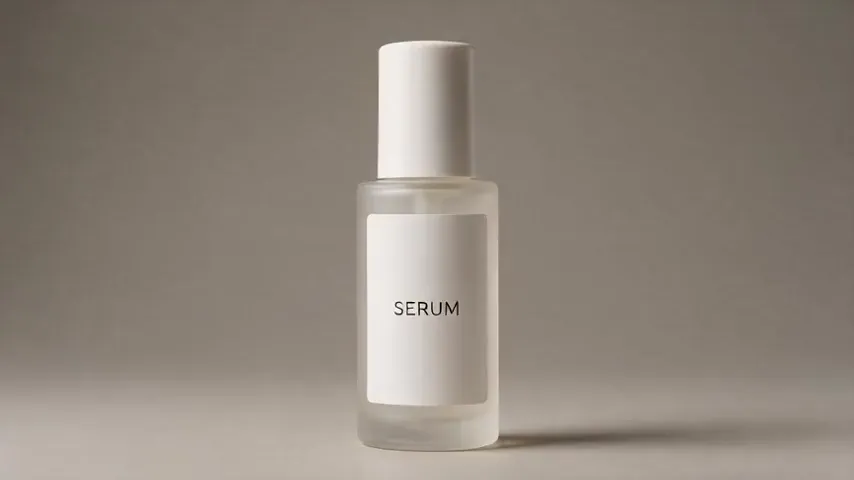
案例 4 实测,完整 4 秒片段(循环播放):到中段和结尾,标签和瓶型仍与源图一致。
5. 从人像到对话镜头
适合: 用已获同意的成年人物肖像测试短对话。
输入: 一张背景简单的成年人物肖像,16:9。
提示词: 保留源图人物的五官、发型、素色蓝衬衫和年龄。人物先看向画外并倾听,转回镜头后说:“我保留了原稿,因为那个小错误反而很真实。”用稳定中近景,人物转回后才缓慢推进。0-7 秒倾听,7-13 秒转头,13-24 秒说话,24-30 秒保留呼吸和表情。声音只有自然室内环境音与已批准的成年声音。不要磨皮、字幕、背景变化或额外说话者。
为什么这样写: 句子短,倾听、转头和说话都有时间。
需要检查: 同意范围、人物身份、口型、视线和声音用途。
实测结果(Seedance 2.5,图生视频,源图作首帧,画幅自适应,480p,4 秒,开启音频,生成耗时 5 分 30 秒): 五官、发型、蓝衬衫和背景都保住了,人物也按提示词先看向画外再转回镜头。没按提示词走: 画面上看不出明显偏差。嘴在动,但台词没有人工听辨,对白是否准确视为未核实。
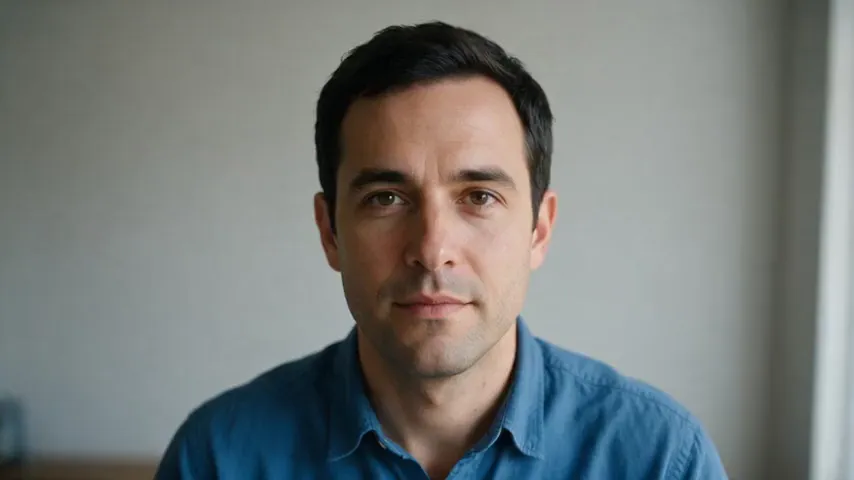
案例 5 实测,完整 4 秒片段(循环播放,静音展示):看向画外再转回,身份和服装保持不变。
6. 让原创插画轻微动起来
适合: 为自有编辑插画增加小幅动作,不破坏原构图。
输入: 一张原创夜间图书馆插画,4:5 或 16:9。
提示词: 保留夜间图书馆的蓝色与琥珀色色板、两名阅读者和纸雕质感。桌灯依次亮起,书页翻动,雨水沿窗户滑下,时钟指针稍微前进。镜头基本固定,只向中间桌子轻推。0-6 秒第一盏灯亮,6-19 秒书页和雨水运动,19-25 秒第二盏灯亮,25-30 秒回到原构图。不要增加阅读者、写实人脸、环绕运镜或书封文字。
为什么这样写: 小动作尊重原画,回到原构图也给循环留下完整结尾。
需要检查: 风格漂移、意外写实化、新增物体和手部变形。
实测结果(Seedance 2.5,图生视频,源图作首帧,画幅自适应,480p,4 秒,关闭音频,生成耗时 5 分 9 秒): 纸雕风格、蓝琥珀配色和构图都保住了,桌灯也亮了。没按提示词走: 两盏灯几乎同时亮起,而不是依次亮;钟针看不出移动;推近也几乎察觉不到。
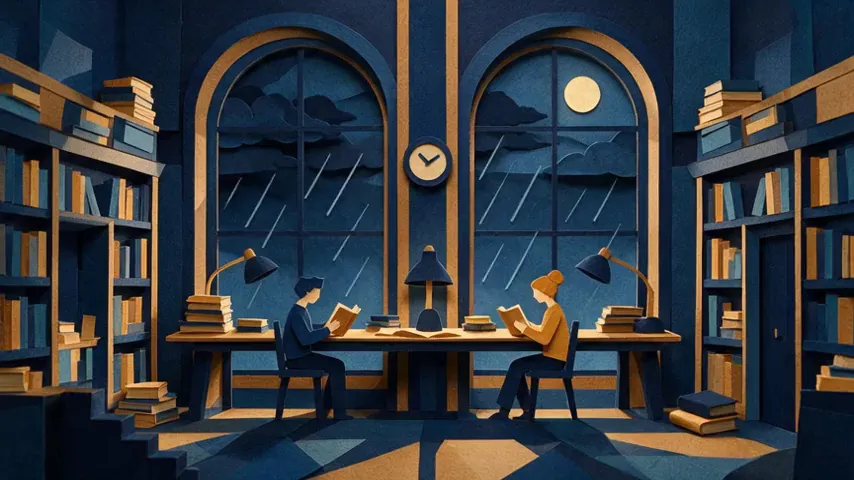
案例 6 实测,完整 4 秒片段(循环播放):风格和构图不变,灯亮了。
参考生视频案例
7. AI UGC 产品演示
适合: 人物身份、产品外观和动作来自不同素材的竖屏演示。
输入: @image1 为已获同意的成年演示者,@image2 为自有产品图,@video1 为自拍手部演示,9:16。
提示词: @image1 只定义演示者身份和服装,@image2 只定义产品,@video1 只定义手部动作与使用顺序。演示者手持产品开场,按动作参考完成三个操作,最后把原样产品和结果放在一起。用手机感中近景,演示时只切一次顶拍,再回到同一中近景。0-4 秒吸引,4-18 秒演示,18-25 秒结果,25-30 秒同时保持产品和结果。不要复制动作视频里的背景、人物或产品,也不要价格、宣传声称、Logo 变化或字幕。
为什么这样写: 每份素材只有一个职责,动作参考不会抢人物或产品身份。
需要检查: 是否误用了动作视频里的细节,产品在顶拍前后是否保持不变。
实测结果(Seedance 2.5,参考生视频,2 张图 + 1 段视频,9:16,480p,4 秒,开启音频,生成耗时 4 分 52 秒): 手持开场、顶拍插入、装菜盖盖都跟着 @video1 走了。没按提示词走: 结尾停在顶拍,没有回到中近景;尾帧还多出一个折叠起来的容器。加一句约束没能解决,原因其实在参考图里,见修改 2。
8. 从预演视频到成片场景
适合: 用自拍走位排练控制动作,再替换成有权使用的场景与服装。
输入: @video1 为两名成年演员的自拍排练,@image1 为原创场地图,@image2 为原创服装板,16:9。
提示词: 两名成年人物按 @video1 的位置与时间行动,@image2 定义简单服装。A 走到窗边,B 留在桌旁,两人同时对窗外灯光做出反应。保留排练的基本走位,但用缓慢横向移动替换固定机位。0-7 秒建立房间,7-18 秒走位,18-25 秒共同反应,25-30 秒保持两人侧面构图。排练视频只控制动作和时间,场地图控制环境与光线,服装板控制服装。不要保留排练人脸、道具或背景。
为什么这样写: 排练只提供走位,临时视觉信息由批准素材替换。
需要检查: 人物位置、误用的排练细节、轴线和共同反应。
实测结果(Seedance 2.5,参考生视频,2 张图 + 1 段视频,16:9,480p,4 秒,关闭音频,生成耗时 5 分 17 秒): 用上了 @image1 的房间和 @image2 的两套服装,@video1 里排练者的脸没有带进来。没按提示词走: A、B 的走位互换了:穿芥末色外套的 B 走向窗边,穿炭灰毛衣的 A 留在桌旁,照搬了 @video1 右侧那个人的路线;也没有横移镜头。把角色和服装绑定后走位就对了,见修改 3。
9. 产品、环境和风格的分工
适合: 多张已批准图片同时参与的电商场景。
输入: @image1 为自有产品,@image2 为自有厨房,@image3 为原创色彩板,@video1 为自拍倒水动作,16:9。
提示词: @image1 定义可重复使用水瓶,@image2 定义厨房布局,@image3 只定义温暖中性色彩,@video1 只定义倒水速度。手把水瓶加满、盖好、放到午餐包旁,再把两者带出画面。用一次齐腰高度跟拍,倒水时插入短特写,随后回到原轴线。0-5 秒空瓶,5-17 秒加水,17-24 秒打包,24-30 秒离场并留空台面。不要复制色彩板物体或动作视频背景,不要标签变化、重复手部和文字。
为什么这样写: 色彩板只管色彩,不会变成场景设计图。
需要检查: 产品身份、手的数量、水位、轴线和素材职责越界。
实测结果(Seedance 2.5,参考生视频,3 张图 + 1 段视频,16:9,480p,4 秒,关闭音频,生成耗时 4 分 41 秒): 水瓶、温暖中性的色调和结尾的空台面都对。没按提示词走: 厨房没按 @image2 来,窗户和橱柜布局都变了;倒水用的是 @video1 里的玻璃壶,动作参考里的道具串了进来;中段看不到手。
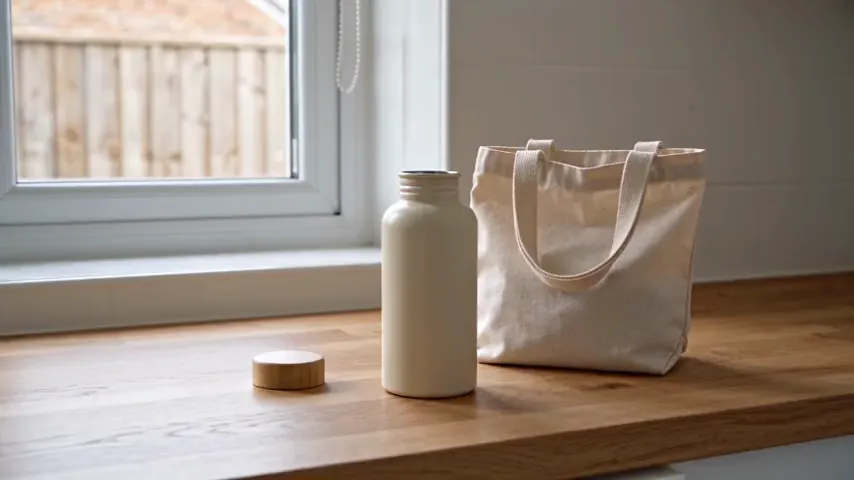
案例 9 实测,完整 4 秒片段(循环播放):产品和色调对了,玻璃壶来自动作视频。
声音和对话案例
10. 带反应停顿的双人对话
适合: 使用已获同意的人物与声音参考测试短对话。
输入: @image1 与 @image2 为成年人物,@audio1 为授权对话试音,16:9。
提示词: @image1 是穿灰色毛衣的 A,@image2 是穿绿色外套的 B。A 问:“你动过那把椅子吗?”B 看向空角落,停顿后回答:“没有。”从双人镜头开始,问句结束后才切到 B,最后回到更广双人镜头并露出空角落。0-7 秒建立房间,7-13 秒问句,13-21 秒观看与停顿,21-25 秒回答,25-30 秒无对话全景。@audio1 只控制台词和停顿。不要增加人物、台词、字幕或超出授权录音模仿声音。
为什么这样写: 停顿也是表演的一部分,镜头等问句结束后才给反应。
需要检查: 说话者、口型、停顿、视线和最后的空角落。
实测结果(Seedance 2.5,参考生视频,2 张图 + 1 段音频,16:9,480p,4 秒,开启音频,生成耗时 4 分 7 秒): 两个人的身份和服装(灰毛衣、绿外套)都对,双人镜头之后按提示词切到 A 肩后看 B 的过肩镜头。没按提示词走: 4 秒内没有回到宽景揭示空角落。我们只看了画面,没有核对台词和停顿。
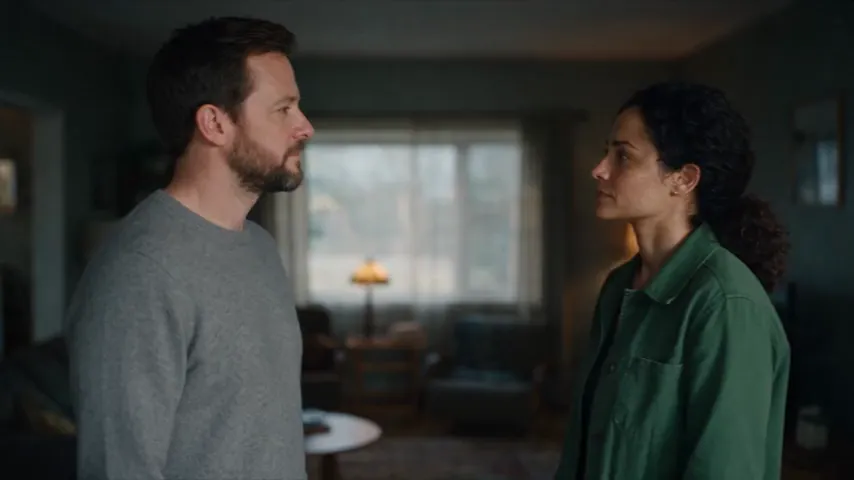
案例 10 实测,完整 4 秒片段(循环播放,静音展示):双人镜头切到 B,片子在宽景揭示前结束。
11. 音乐节奏驱动的几何动画
适合: 不含歌词和品牌画面的授权节奏测试。
输入: @audio1 为原创 30 秒器乐循环,@image1 为原创几何风格帧,1:1 或 9:16。
提示词: 三个纸质形体使用 @image1 的色彩和纹理。形体在主节拍上折叠,在切分音上滑动,音乐短暂停顿时保持不动,最后组成平衡构图。镜头固定,最后 8 秒缓慢推进。动作跟随 @audio1 的开场、密集段、停顿和收束,不要求每拍切镜。@audio1 是唯一声轨。不要 Logo、字母、人脸或对现有音乐视频的模仿。
为什么这样写: 动作对应音乐段落,观众仍有时间看清形状。
需要检查: 主要段落响应、停顿和最后构图的保持时间。
实测结果(Seedance 2.5,参考生视频,1 张图 + 1 段音频,1:1,480p,4 秒,开启音频,生成耗时 4 分 51 秒): 纸张质感和珊瑚红、墨绿、芥末黄配色都跟了 @image1,形体也有折叠并聚到一起。没按提示词走: 4 秒只覆盖 30 秒音乐的开头,看不到停顿段;结尾是几块纸叠在一起,而不是平衡构图。
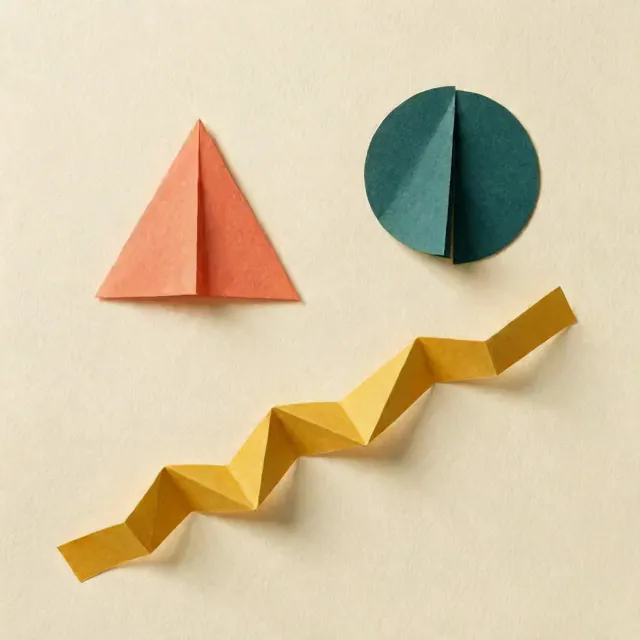
案例 11 实测,完整 4 秒片段(循环播放,静音展示):质感和配色来自风格帧,结尾叠成一团。
12. 声音为主的竖屏口播
适合: 已获同意的说话者使用授权录音做社交解释视频。
输入: @image1 为成年说话者,@audio1 为 22 秒原创录音,9:16。
提示词: @image1 定义说话者、素色服装和中性家庭办公环境。说话者完成 @audio1,只指一次纸上草图,再回看镜头并点头收尾。用稳定胸部以上手机构图,主要观点处只做一次轻推,不切镜。0-3 秒安静开场,3-25 秒播放授权录音,25-30 秒点头并保持。不要字幕、新观点、背景变化或超出明确同意范围的声音克隆。
为什么这样写: 视觉动作足够简单,不会抢语音内容。
需要检查: 口型、授权文案、手部结构、眼神和结尾稳定性。
实测结果(Seedance 2.5,参考生视频,1 张图 + 1 段音频,9:16,480p,4 秒,开启音频,生成耗时 3 分 49 秒): 人物、藏青 T 恤和家庭办公背景都保持住了,片子中段人物在说话。没按提示词走: 没有指向纸张的手势;@image1 里墙上那张空白纸,从首帧起就被画上了一个方框。台词没有人工听辨。
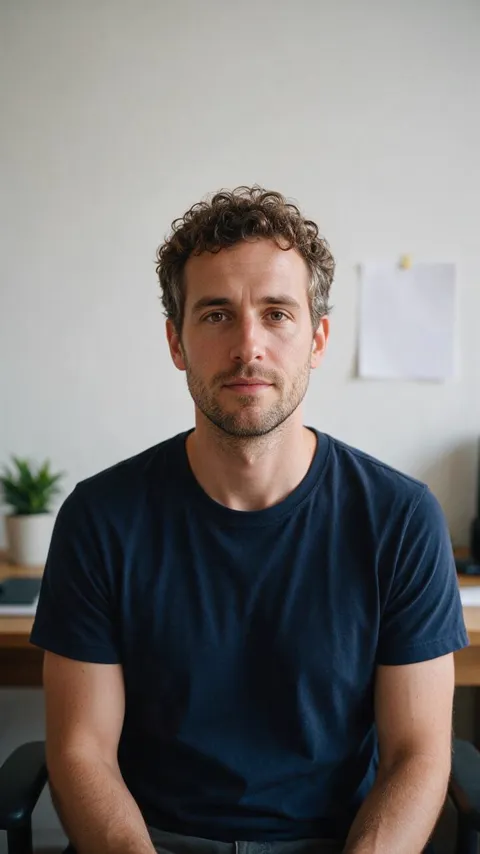
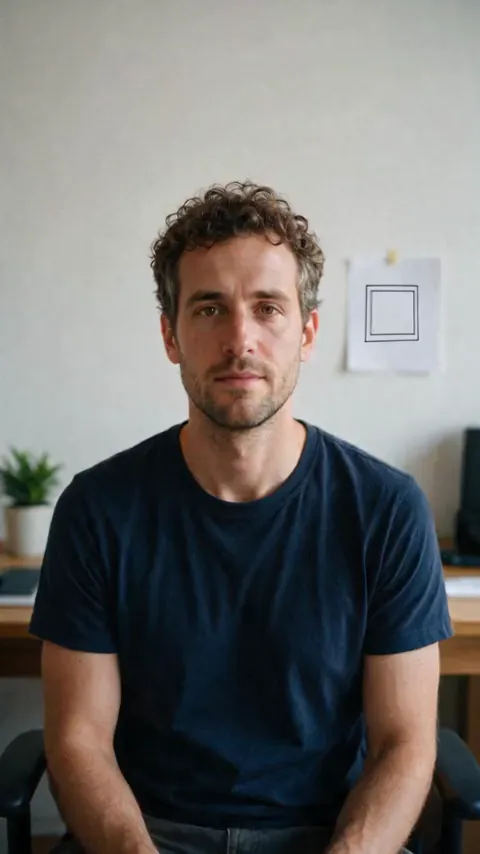
案例 12:左为参考图,右为完整 4 秒生成结果(循环播放,静音展示)。空白纸变成了草图。
按实际生成时长写「时间」
12 条实测里最明显的规律是:提示词按 30 秒规划了四段,而片子只有 4 秒时,Seedance 2.5 会把时间花在前一两段上,后面的直接丢掉。雨夜站台停在火车驶过,旅客还没做决定;UGC 演示没有回到收尾的中近景;双人对话没有拍到宽景揭示;音乐动画也没出现停顿段。模型并没有把四段都压进 4 秒,而是演完开头就停了。
在我们的测试里,按实际时长重写「时间」一行就能解决。修改 1中,拌面提示词其他字段一字不改,只把 30 秒的时间分段换成 4 秒版本,成品碗开场和夹面收尾就都出现了。
| 实际生成时长 | 「时间」一行的写法 | 保留什么 |
|---|---|---|
| 4–5 秒 | 0-1 秒开场;1-3 秒一个动作;3-4 秒停在结尾 | 一个动作和结尾画面 |
| 10 秒 | 0-2 秒开场;2-7 秒主要动作;7-10 秒结果并停住 | 两段,结尾停 2 秒 |
| 15 秒 | 0-3 秒开场;3-9 秒动作;9-13 秒结果;13-15 秒停住 | 三段,一种运镜 |
| 30 秒 | 0-5 秒开场;5-16 秒展开;16-25 秒证明;25-30 秒收尾 | 四段,即完整案例 |
这些写法是我们根据实测给出的建议,不是模型文档里的控制项。如果想先用 4 或 5 秒草稿省积分来测一个 30 秒创意,先把「时间」一行改短;否则草稿只能告诉你开头怎么样,结尾要等完整时长生成才知道。
参考素材职责表
| 职责 | 可以控制 | 不应意外控制 |
|---|---|---|
| 身份 | 人脸、服装、产品几何形状 | 镜头路径或无关背景物体 |
| 产品 | 形状、材质、标签位置 | 演示者外观或房间布局 |
| 环境 | 建筑、光线方向、空间布局 | 人物身份或产品设计 |
| 动作 | 走位、手势顺序、速度 | 人脸、服装或临时道具 |
| 风格 | 色板、媒介、纹理、对比 | 精确构图或受保护角色设计 |
| 声音 | 台词、节奏、环境音、停顿 | 视觉身份,除非明确指定 |
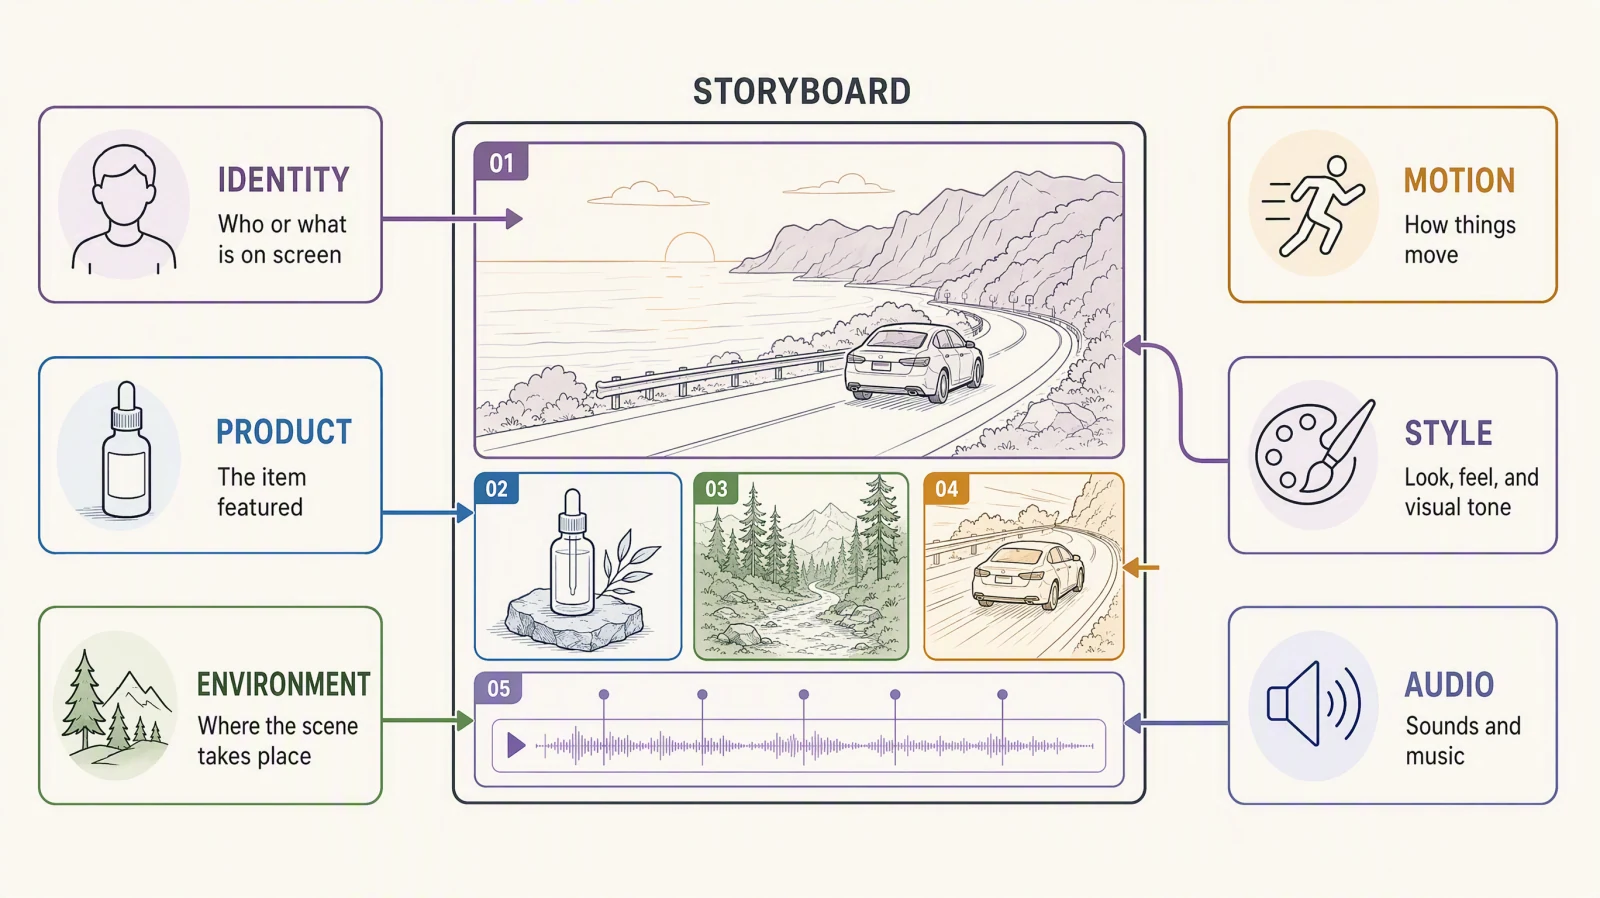
明确素材职责,可以减少从错误参考里借来人物或物体。
如果两张图都在定义同一产品,只保留一张主参考。如果排练视频里有临时人脸和道具,要明确它只控制动作。每份文件都能影响一切时,出错后就很难定位。
Seedance 2.5 提示词大全(可直接复制)
上面 12 个案例是完整的 30 秒简报。下面这 12 条是短版:每条一段话,沿用同一套七个字段的写法,适合先出 5–15 秒的草稿;哪条效果好,再把它展开成带时间分段的完整简报。每个提示词块下方都有「在 SeedVideo AI 里试试这条提示词」按钮,点开即自动填入生成器。
产品类
- 主体
- 湿润黑色石板上的一瓶无品牌琥珀色玻璃精华液
- 动作
- 瓶身静止,一滴水珠沿着标签缓慢滑落
- 镜头
- 固定微距,结尾两秒缓慢推近
- 声音
- 安静的室内环境音和一声轻微滴水
- 约束
- 标签形状不变,不出现手、文字和多余道具
- 主体
- 明亮影棚水泥地上的一双无品牌白色皮质运动鞋
- 动作
- 鞋子旋转四分之一圈,柔光从鞋头扫过
- 镜头
- 贴地的低角度固定镜头
- 声音
- 无
- 约束
- 缝线和鞋底形状全程一致,不出现 logo,只做一次扫光
电影感
- 主体
- 黄昏时分,一名穿羊毛外套的灯塔看守人站在石阶上
- 动作
- 他走上三级台阶,停下,抬头看着头顶的灯亮起
- 镜头
- 低角度,随灯光缓慢上摇
- 声音
- 风声和远处的海浪,没有对白
- 约束
- 只有一个人,外套和面容保持一致,不出现额外光源
- 主体
- 雾中的公交站,一名穿红色雨衣的年轻女性
- 动作
- 车灯靠近,她向前一步,灯光却驶过没有停下
- 镜头
- 侧面中景,固定
- 声音
- 引擎驶过、湿轮胎声,没有对白
- 约束
- 雨衣颜色不变,路牌不可辨认,雾的浓度稳定
竖屏社交(9:16)
- 主体
- 竖屏 9:16,一只手把新鲜可颂放到白色盘子上
- 动作
- 撕开可颂露出层次,冒出一小股热气
- 镜头
- 固定特写,适合手机观看的构图
- 声音
- 清脆的酥皮声,没有人声
- 约束
- 只有一只可颂,背景干净,顶部留出字幕位置
- 主体
- 竖屏 9:16,日出时分一名跑者在跑道上系鞋带
- 动作
- 她站起、呼气,然后三步冲刺出画
- 镜头
- 低机位固定
- 声音
- 呼吸和脚步声
- 约束
- 服装一致,没有其他跑者,太阳位置不变
图生视频
完整保留上传的人像:面部、发型、服装和构图。加入缓慢眨眼、轻微呼吸和微风吹动头发。镜头:静止。声音:无。约束:身份、背景和光线都不改变,动作保持细微。
完整保留上传的产品照片。让产品在底座上旋转 30 度,高光随之从表面划过。镜头:固定。声音:无。约束:标签和外形不变,背景不变,不新增物体。
参考生视频(R2V)
用 @image1 决定角色的面部、发型和服装,用 @image2 只决定环境。动作:角色走到窗前并推开窗。镜头:从背后缓慢跟随。声音:开窗后街道噪音渐起。约束:身份以 @image1 为准,优先于 @image2 里的任何人物;不出现额外的人。
用 @image1 决定产品,用 @video1 决定运镜和节奏。动作:用 @image1 里的产品复现 @video1 的环绕和最后的停止。声音:无。约束:产品外形优先于运动片段里的任何形状。
对话与声音
- 主体
- 明亮柜台后一名系黑色围裙的咖啡师
- 动作
- 她把杯子递向镜头并说:"单一产地,不加糖,你喜欢的那种",然后点头
- 镜头
- 固定中近景
- 声音
- 自然语速,台词下方铺一点咖啡馆环境音
- 约束
- 只有这一句台词,不出现文字和 logo
- 主体
- 木质码头上的一位老渔民
- 动作
- 他在旧手机上读完一条消息,放下手机,望向灰色的海面
- 镜头
- 侧面缓慢推近
- 声音
- 只有海鸥和水声,没有对白和音乐
- 约束
- 布满风霜的面容保持一致,阴天光线稳定
常见提示词错误
| 错误 | 难以判断的部分 | 更好的修改 |
|---|---|---|
| 目标太多 | 每个目标都没完成 | 保留一个视觉承诺和一个结尾 |
| 方向冲突 | 镜头与主体动作互相争抢 | 只保留一种主运镜 |
| 动作模糊 | 画面用无意义移动填时间 | 用可见动词并写明执行者 |
| 没有结尾 | 视频在动作中突然停止 | 把最后一段留给稳定画面 |
| 参考未分工 | 风格、身份和背景互相污染 | 每份素材只指定一个主要职责 |
| 负面约束太长 | 重要固定项被埋没 | 只保留可检查的短约束 |
| 两个主体同等重要 | 模型只顾一个,另一个漂移或消失 | 指定一个主角,另一个只做反应 |
| 时间段重叠 | 两个动作抢同一段时间 | 每段单独给时间和一个动作 |
| 风格词互相冲突 | “纪录片”“动漫”“电影感”互相抵消 | 每条提示词只保留一种风格 |
为什么 Seedance 2.5 会忽略部分提示词
结果漏掉某条指令时,原因通常在提示词本身,而不是缺少某个控制项:
- 主体互相争抢。“咖啡师和顾客聊天,一只狗跑过”让三个角色同样重要。改成一个主角:“咖啡师拉花后抬头,门口的顾客做出反应。没有其他人和动物。”
- 关键指令埋在长段落后面。 越靠后的细节越容易被丢掉。把不能妥协的约束(标签可读、脸不变)单独写成一行。
- 模式不匹配。 在文生视频里要求“产品和照片一模一样”是做不到的,因为模型没有那张照片。改用图生或参考生视频,给素材指定职责,而不是更用力地描述它。
改好提示词后重新生成一次,在两版的相同时间点对比,再决定下一步改什么。
不要编造当前界面没有的控制项。页面没有明确显示负面提示词、镜头控制滑块或局部编辑指令时,就不要把它们写成已有功能。必要约束可以用普通语句放在主提示词里。
一次只改一个变量
- 保存基准版的提示词和参考素材。
- 完整看一遍视频,不立即改文字。
- 找出最大问题:主体、动作、镜头、时间、声音还是结尾。
- 只修改对应字段。
- 其他字段保持不变,再生成一版。
- 在相同时间点比较两版,尤其是开头和最后一帧。
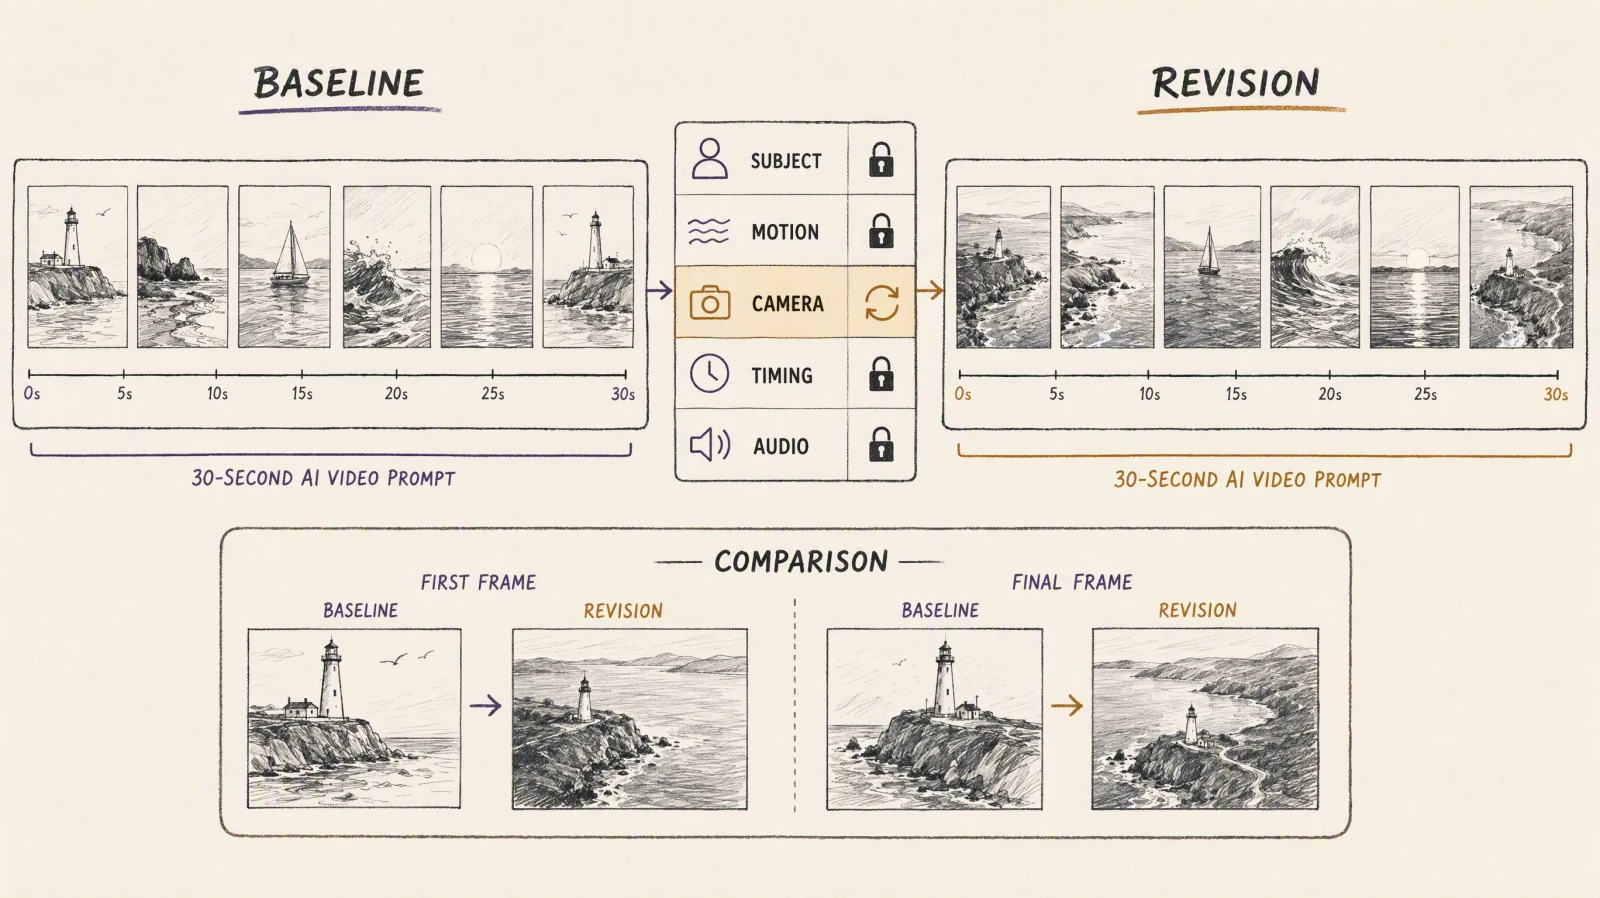
一次只改一项,才容易判断哪个修改真正有用。
产品变形时,先收紧身份或产品参考职责,不要先改运镜。中段拖沓时,先改时间分配,不要再塞新动作。对话太赶时,缩短句子或增加停顿,不要改画面风格。
前后对比:三次只改一行
有三条实测出现了明确的偏差,我们对每条只改提示词里的一行,用相同的素材和参数重新生成。提示词其余部分一字不改。
| 案例 | 第一版问题 | 改了哪一行 | 第二版结果 |
|---|---|---|---|
| 3 | 没用成品碗开场,颜色漂移 | 时间:按 4 秒重写 | 开场、颜色和结尾都对了;拌面变成了浇汁 |
| 7 | 结尾出现两个容器 | 约束:“每个镜头只有一个容器” | 结尾回到了中近景;仍是两个容器,因为参考图里就有两个 |
| 8 | A、B 走位互换 | 动作:每个角色绑定一套服装 | 走位对了;一件配饰跑到了另一个角色身上 |
修改 1:案例 3,按实际时长重写时间
第一版以生料开场,面条最后变成橙色。第二版只替换了「时间」一行(测试用的是英文提示词):
Timing: 0-1s finished bowl from overhead; 1-3s one toss of the noodles; 3-4s lifted bite over the same finished bowl.
这次成品碗出现在开场,颜色保持稳定,尾帧在同一个碗上方挑起一口面。也出现了新的偏差:拌面变成了浇汁,俯拍变成了约 45° 斜拍,筷子换成了叉子。下面是改后的 4 秒版完整提示词(保留英文原文),可以直接试:
- Subject
- a home cook making a bright citrus noodle bowl in a clean kitchen, using generic unbranded ingredients
- Action
- open on the finished bowl, rewind the visual idea into preparation, toss the noodles, then return to the finished bowl with steam and a lifted bite
- Camera
- overhead hook, two fast close inserts for zest and sauce, medium side shot for the toss, locked close-up for the ending
- Timing
- 0–1sfinished bowl from overhead
- 1–3sone toss of the noodles
- 3–4slifted bite over the same finished bowl
- Audio
- crisp kitchen sounds with a light rhythmic pulse, no spoken recipe and no generated captions
- Reference roles
- none
- Constraints
- one bowl, stable ingredient colors, safe utensil handling, no labels, no impossible food transformations
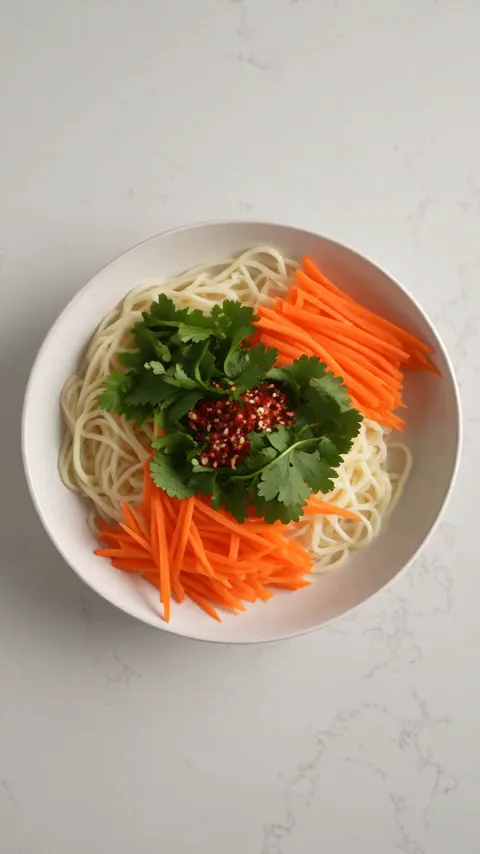
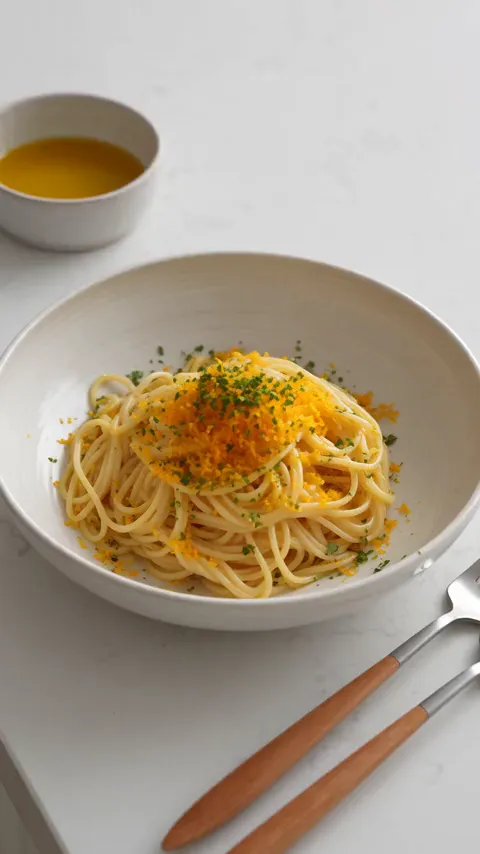
案例 3,两次生成的完整 4 秒片段(循环播放)。左:30 秒的时间分段;右:4 秒的时间分段。
修改 2:案例 7,该改参考图而不是加约束
第一版结尾在装满的容器旁边多出一个折叠容器。第二版只在「约束」一行开头加了一句:
Constraints: exactly one container in every shot, the one from @image2;
结尾有改善:片子回到了演示者的中近景,第一版没有做到。但演示者手里仍然是两个容器,一个装满、一个折叠。原因在 @image2:我们用的替身产品图本身就拍了两个容器,一个打开、一个折平,模型就把“两个容器”当成了产品的一部分。提示词里的一句话压不过图片。如果产品参考图里有两件东西,先裁剪或重拍成只有一件,再考虑加约束。
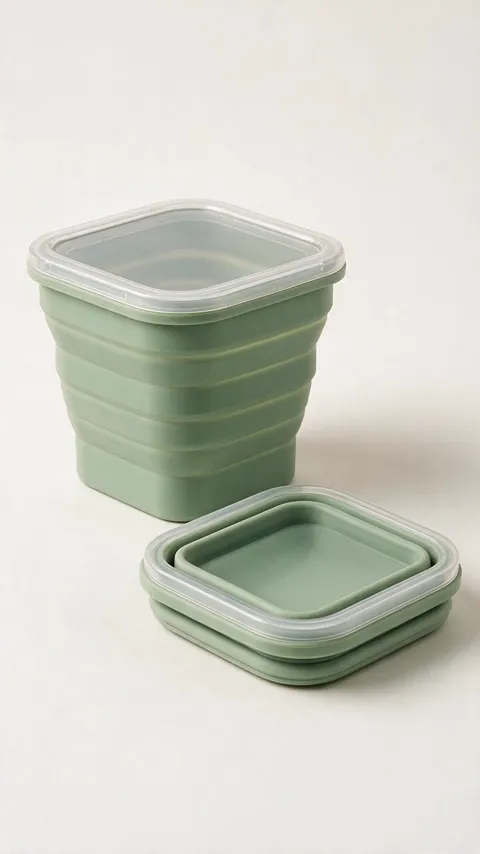
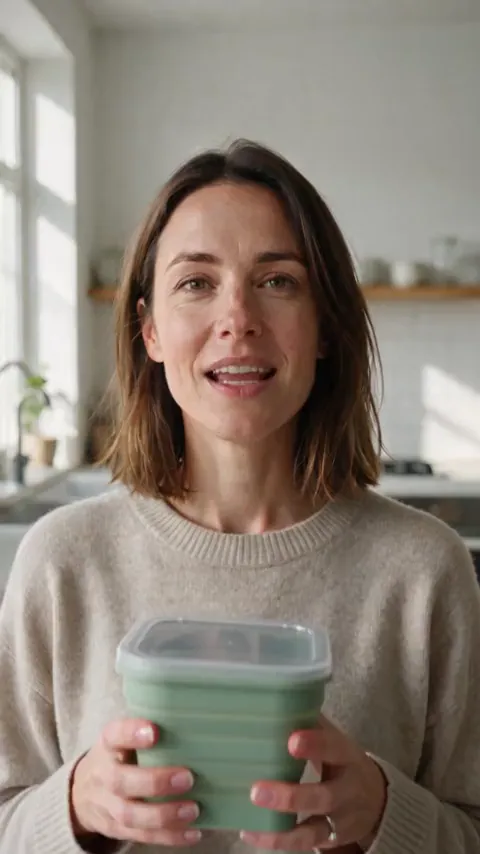
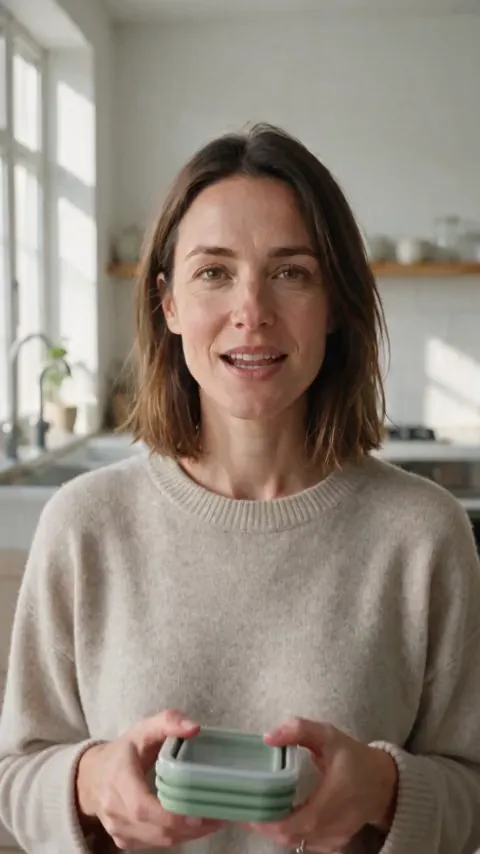
案例 7:左为产品参考图,中为第一版,右为修改版,两段都是完整 4 秒片段(循环播放,静音展示)。两版都照搬了参考图里的两个容器。
修改 3:案例 8,把角色和服装绑定
第一版里,穿芥末色外套的角色走向窗边,而提示词把这个动作给了 A。第二版改写「动作」一行,让每个角色对应服装板上一套有名字的服装:
Action: character A, wearing outfit A from @image2 (charcoal sweater), crosses to the window; character B, wearing outfit B from @image2 (mustard overshirt), waits by the table; then both react to a light outside.
走位这次对了:穿炭灰毛衣的 A 走向窗边,穿芥末色外套的 B 留在桌旁。但又暴露出新的串用:服装板上属于 A 的毛线帽戴到了 B 头上;横移镜头和共同反应也仍然没有。服装板里有配饰时,要按角色写明,或者干脆从服装板上拿掉。
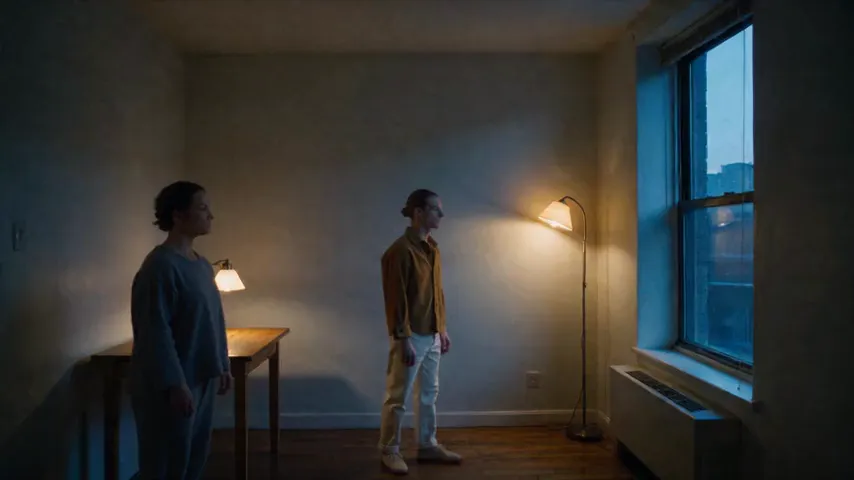
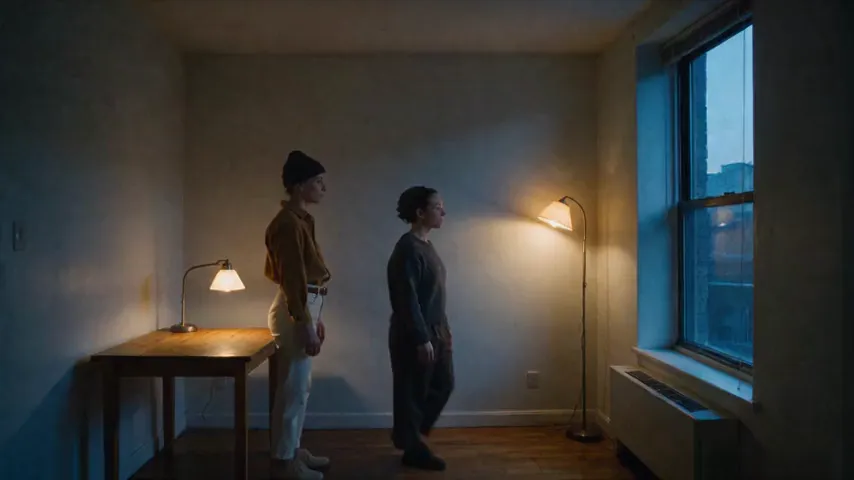
案例 8,两次生成的完整 4 秒片段(循环播放)。上:原「动作」写法;下:角色与服装绑定后。
三次修改指向同一个结论:按实际时长写的「时间」、写明谁穿什么的「动作」,都修好了各自针对的问题;和参考图相矛盾的约束则没有用。结果反复照搬某个错误时,先看看参考图里实际画了什么,再决定要不要加规则。
权利和安全说明
只使用你拥有或已获许可的提示词、图片、视频、音频、肖像、声音和品牌素材。同意使用人像,不等于同意克隆声音或用于商业广告。一段参考视频还可能包含音乐、艺术品、Logo 和其他需要单独授权的人物。
在批准素材准备好前,模板尽量保持通用。不要用公众人物、影视角色、可识别电影场景或竞品 Logo 作为风格与身份捷径。发布前检查标签变形、编造卖点、意外人物和不安全动作。
常见问题
Seedance 2.5 提示词应该写多长?
长度足以写清七个字段,同时保证每条指令都能检查。结构清楚的短简报比密集长段落更容易修改。不会改变画面决策的形容词可以删掉。
30 秒提示词应该有多少个镜头?
先用两到四个容易读懂的段落。更多切镜会增加连续性工作。主体动作随时间变化清楚时,单一长镜头也可以。
可以使用 @image1、@video1 和 @audio1 吗?
SeedVideo AI 模型文档在 2026 年 8 月 2 日核验时支持这些按数组顺序对应的标记。只在当前确认支持参考标记的流程中使用。Dreamina 和其他产品可能使用不同命名。
需要写负面提示词吗?
只有当前界面明确提供并说明了负面提示词字段时才使用。否则,把少量重要内容写进主提示词的“约束”。不要假设存在独立控制项。
声音提示词怎么写?
说明视频需要对话、环境音、音乐、音效还是安静,再写它与画面的大致关系,例如揭示前停顿。使用已授权声音,不要要求模仿未获同意的人。
如何保持角色一致?
使用一份已批准身份参考,重复稳定的服装和场景细节,减少不必要换景。完整检查人脸、头发、服装、身体比例和视线。
生成失败后应该改什么?
先改与最大可见问题对应的字段。动作模糊就收紧动作,构图漂移就简化运镜,没有结尾就重写时间。下一次对比时,其他字段保持不变。
为什么 Seedance 2.5 会忽略部分提示词?
通常是两个主体或两个动作抢同一段时间,关键约束放在长段落末尾,或者要求文生视频保留只有图片、参考素材才能提供的东西。见上方「常见提示词错误」里的检查清单。
30 秒的提示词可以先用 4 秒测试吗?
可以,但先把「时间」一行改成 4 秒版本。我们按 4 秒、480p 实测 12 条时,保留 30 秒时间分段的提示词大多只演出前一两段,结尾被跳过;拌面案例换成 4 秒的时间分段后,开场和结尾都出现了。
时间段是按帧精确的指令吗?
不是。除非当前产品明确说明了更强的时间控制,否则它只是内容规划结构。生成后要完整检查,不要默认每个转场会落在精确秒数。
来源与方法
- Dreamina Seedance 2.5 提示词指南,2026 年 8 月 2 日核验,用于确认其公开的 30 秒规划和参考提示方式。
- Dreamina Seedance 2.5 模型页,2026 年 8 月 2 日核验,用于确认其对 30 秒生成和多模态参考流程的公开描述。
- SeedVideo AI Seedance 2.5 页面,2026 年 8 月 2 日核验,用于确认模型入口、输入模式和当前产品说明。
- SeedVideo AI 模型文档,2026 年 8 月 2 日核验,用于确认参考数量、模式判断和
@image1、@video1、@audio1语法。 - 一手实测,2026 年 10 月 13 日:12 个完整案例各用 Seedance 2.5 以 480p、4 秒生成一次;案例 3、7、8 另用相同素材和参数做了只改一行的修改版。输入素材为 AI 生成的替身图片和动作短片、合成语音和原创合成音乐;记录只描述画面。
文中 12 个提示词案例均为原创可改写模板,不是官方推荐,也不保证特定结果。
开始写你的 Seedance 2.5 提示词
打开 SeedVideo AI 的 Seedance 2.5 页面,选择与手头素材匹配的模式,再从一个模板开始。把所有占位内容换成已批准素材,先生成基准版,之后一次只改一个字段。