Guida ai prompt Seedance 2.5: 36 prompt + 12 esempi completi da 30 secondi
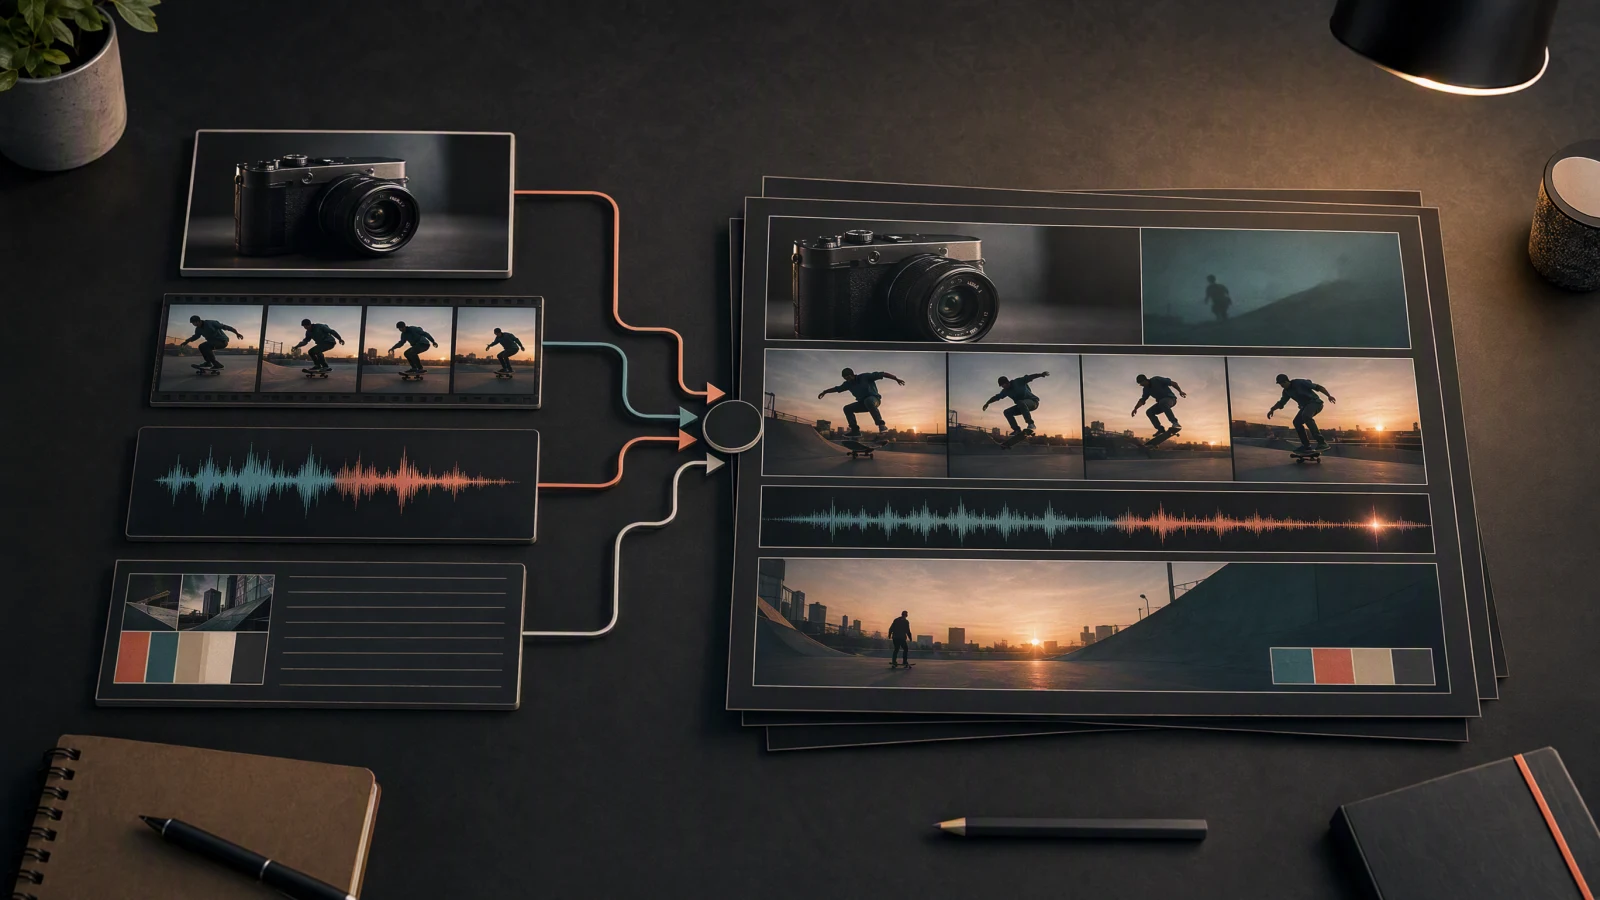
Considera un prompt per Seedance 2.5 come una nota di regia compatta. Parti dal soggetto, poi indica azione, comportamento della camera, timing, direzione audio, ruoli dei riferimenti e vincoli. Per una clip di 30 secondi, dividi l'idea in aggancio, sviluppo, prova e risoluzione, così il finale non arriva per caso. Scegli la modalità di generazione prima di scrivere: il testo va bene per una scena nuova, un'immagine fissa aspetto e composizione, primo e ultimo fotogramma controllano il percorso visivo, e la modalità con riferimenti assegna compiti separati a immagini, video o audio. I 12 modelli originali qui sotto sono fatti per essere riscritti. Sostituisci prodotti, ambientazioni e personaggi generici con materiale tuo o che hai il permesso di usare, poi genera una versione di base e rivedi una variabile alla volta. Ognuno dei 12 esempi ora mostra il nostro render di prova con Seedance 2.5 di quel prompt esatto, come breve clip in loop, insieme alle impostazioni usate e alla parte che il modello non ha rispettato.
In breve
- Usa questo ordine: Soggetto -> Azione -> Camera -> Timing -> Audio -> Ruoli dei riferimenti -> Vincoli.
- Pianifica 30 secondi in quattro momenti: aggancio, sviluppo, prova e risoluzione.
- Adatta il prompt alla modalità (testo, immagine, primo e ultimo fotogramma o riferimenti) prima di aggiungere dettagli.
- Dai a ogni riferimento un solo compito. Non chiedere a due asset di definire la stessa identità o lo stesso stile.
- Tratta ogni esempio come un modello da riscrivere, poi controlla l'intera clip e cambia una variabile.
- Abbiamo generato tutti i 12 prompt completi a 4 secondi e 480p: il modello ha eseguito soprattutto i primi momenti e ha lasciato cadere il finale, quindi scrivi la riga Timing per la durata che generi davvero.
- Se preferisci copiare e provare invece di leggere, apri la libreria di prompt per Seedance 2.5: ogni prompt ha un pulsante Try per provarlo con un clic. Gli esempi per le versioni precedenti sono in Seedance prompts.
Risposta rapida
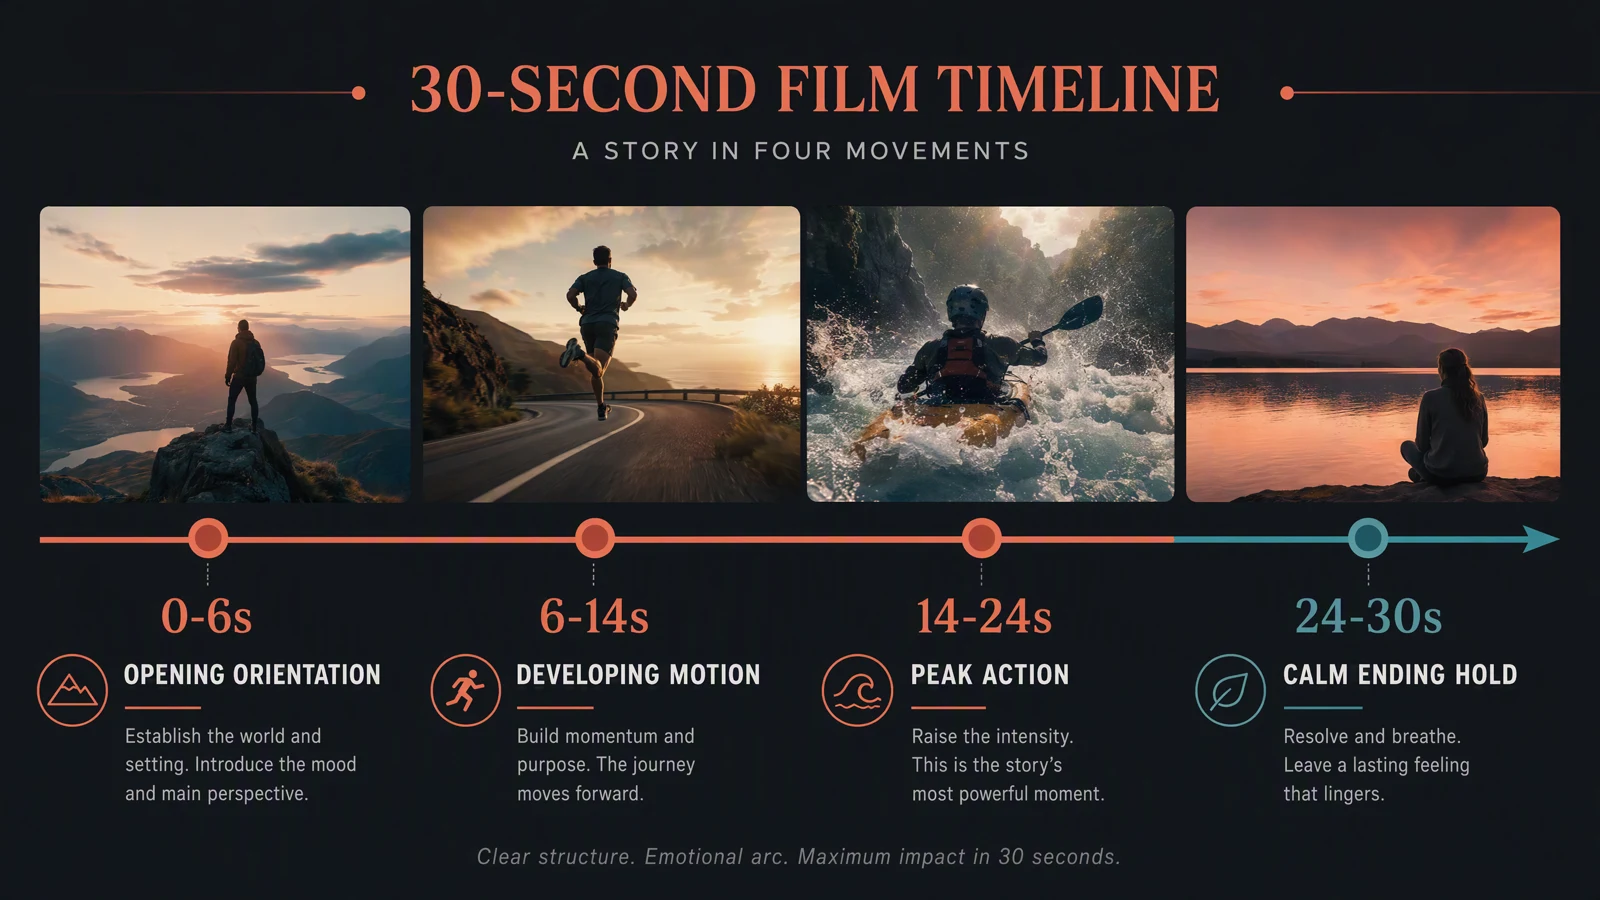
Un prompt utile per Seedance 2.5 ti dà sette elementi da verificare dopo la generazione: un soggetto, un'azione leggibile, un'idea di camera principale, una sequenza temporizzata, l'intenzione audio, il compito di ogni riferimento e i dettagli che non devono cambiare. Per un video di 30 secondi, scrivi quattro momenti invece di un lungo paragrafo: 0-5 secondi per l'aggancio, 5-16 per lo sviluppo, 16-25 per la prova o l'escalation e 25-30 per la risoluzione. Questi tempi sono un aiuto alla pianificazione, non controlli garantiti al fotogramma. Parti dalla modalità più semplice in grado di preservare ciò che conta, poi aggiungi riferimenti solo quando ogni asset ha un ruolo chiaro. Se vuoi solo prompt da copiare, salta ai 24 spunti brevi; il riepilogo rapido delle impostazioni elenca durate, risoluzioni, limiti dei riferimenti e tariffe in crediti su cui si basano quei prompt. Per vedere come si comportano in pratica gli esempi completi, vai a come abbiamo testato i 12 esempi e alle revisioni prima e dopo.
Aggiornato e verificato il 13 ottobre 2026, con render di prova di prima mano su Seedance 2.5 di tutti i 12 esempi completi, oltre al generatore web di SeedVideo AI, alla pagina del modello Seedance 2.5 e alla documentazione dei modelli.
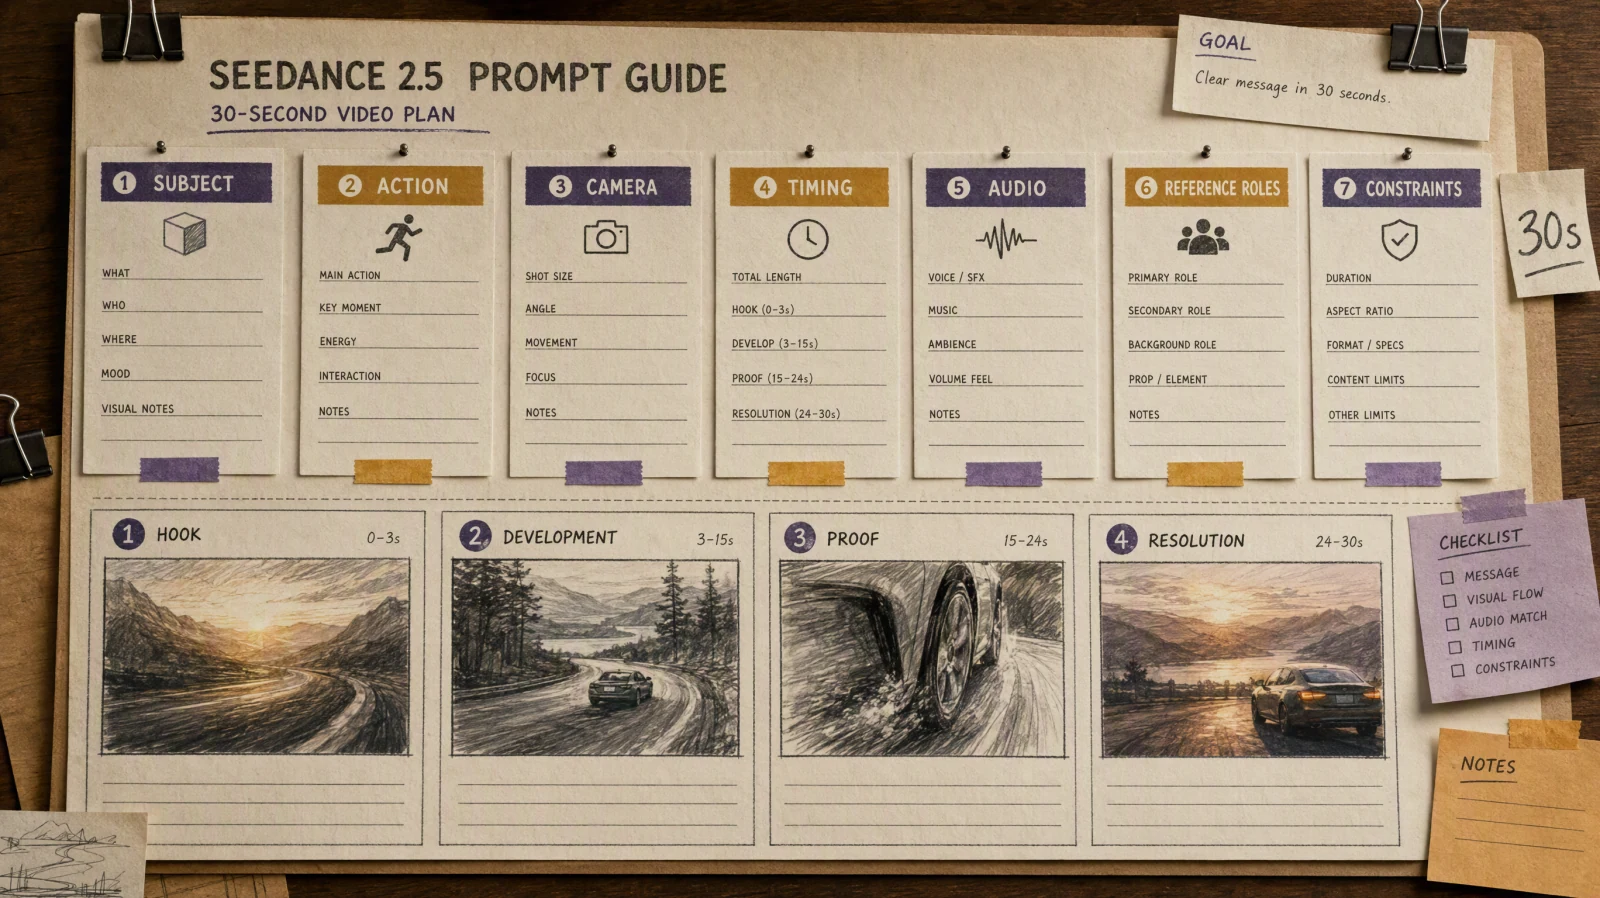
Un prompt da 30 secondi funziona meglio come brief di regia con sette campi distinti.
Anatomia di un prompt Seedance 2.5
Usa questo schema a sette campi. I nomi dei campi restano in inglese, come nei prompt di esempio: Subject (soggetto), Action (azione), Camera, Timing, Audio, Reference roles (ruoli dei riferimenti) e Constraints (vincoli).
- Subject
- Who or what must remain recognizable?
- Action
- What changes on screen?
- Camera
- What shot size and movement should guide the viewer?
- Timing
- What happens in each beat, and how does the clip end?
- Audio
- What dialogue, ambience, rhythm, or silence supports the action?
- Reference roles
- Which asset controls identity, product, environment, motion, style, or audio?
- Constraints
- What must stay fixed, and what should be omitted?
Sostantivi e verbi concreti fanno più lavoro di lunghi elenchi di aggettivi. "Una tazza in ceramica ruota una volta mentre la camera passa da un piano medio a un primo piano" è più facile da valutare di "una presentazione di prodotto bella, premium e cinematografica". Se il risultato non rispetta il brief, la prima versione ti dice quale campo va sistemato.
Per formule di prompt generali ed esempi più brevi, usa la guida ai prompt di Seedance. Per un vocabolario mirato di panoramiche, carrelli, orbite e inquadrature in movimento, consulta la guida ai prompt per i movimenti di camera nei video AI.
Come cambia il prompt a seconda della modalità
| Modalità | Input di partenza ideale | Campi su cui insistere | Come citare i riferimenti | Cosa controllare per primo |
|---|---|---|---|---|
| Da testo a video | Brief scritto della scena | Soggetto, azione, camera, timing | Nessun marcatore di asset necessario | Se scena e movimento sono leggibili |
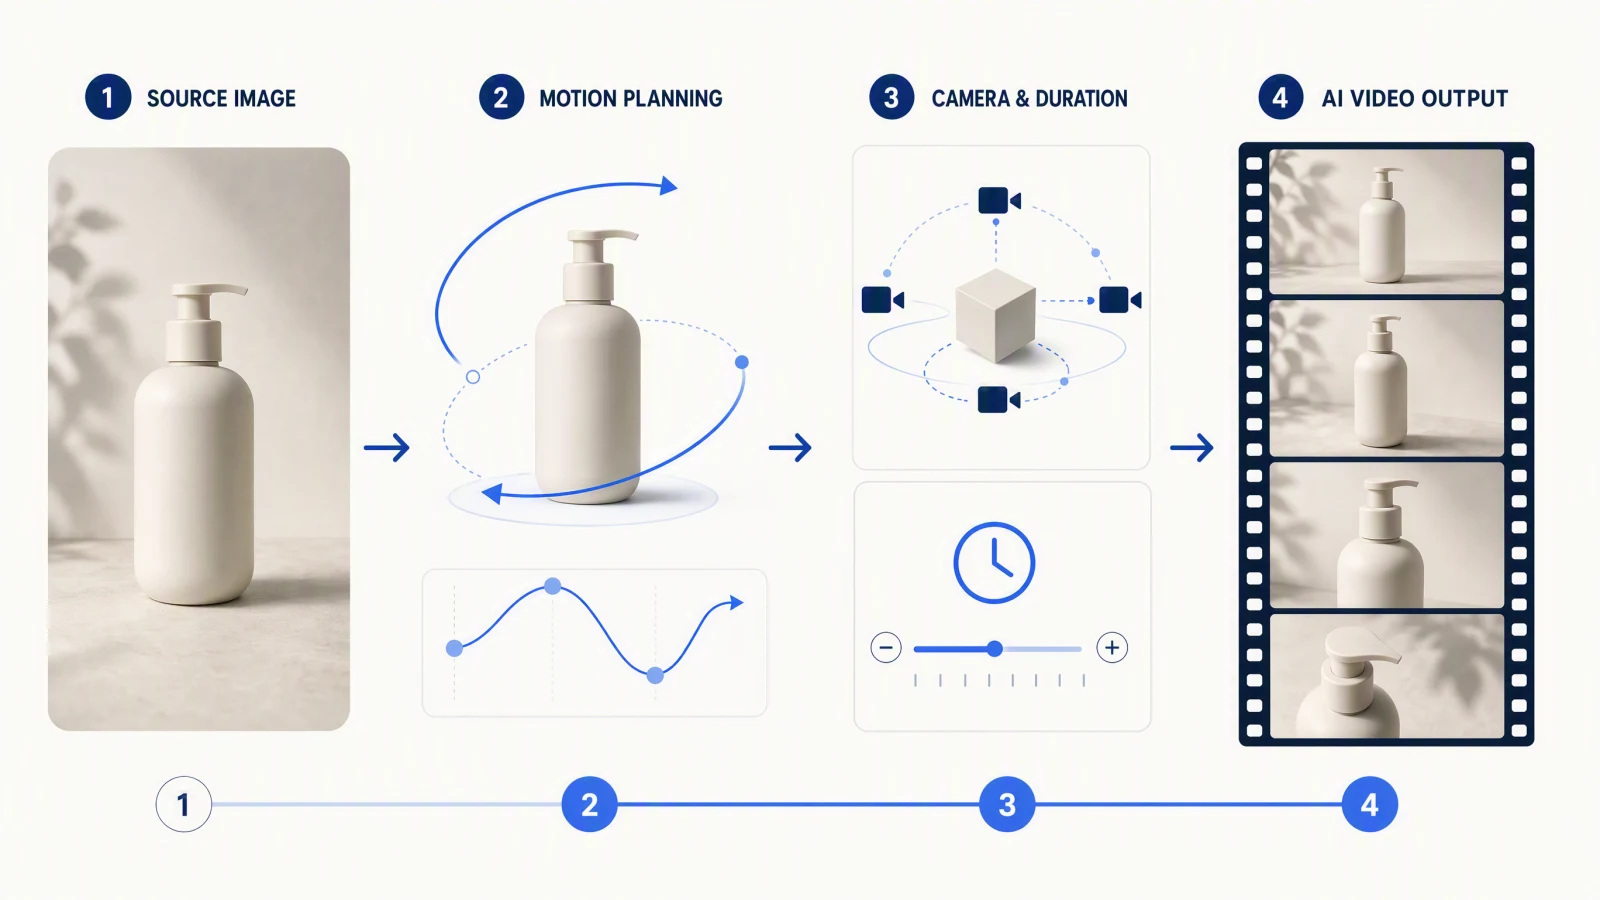
| Da immagine a video | Un'immagine tua o con licenza | Azione, camera, aspetto da mantenere | Descrivi cosa deve preservare l'immagine sorgente | Identità, geometria e deformazioni indesiderate |
| Primo e ultimo fotogramma | Due immagini compatibili | Percorso della transizione, timing, finale | Assegna separatamente la composizione d'apertura e quella finale | Se il movimento collega in modo naturale i due fotogrammi |
| Da riferimenti a video | Immagini, video o audio con compiti separati | Ruoli dei riferimenti, vincoli, timing | Nel flusso con riferimenti documentato da SeedVideo AI, @image1, @video1 e @audio1 seguono l'ordine dell'array | Se ogni riferimento influenza solo il ruolo assegnato |
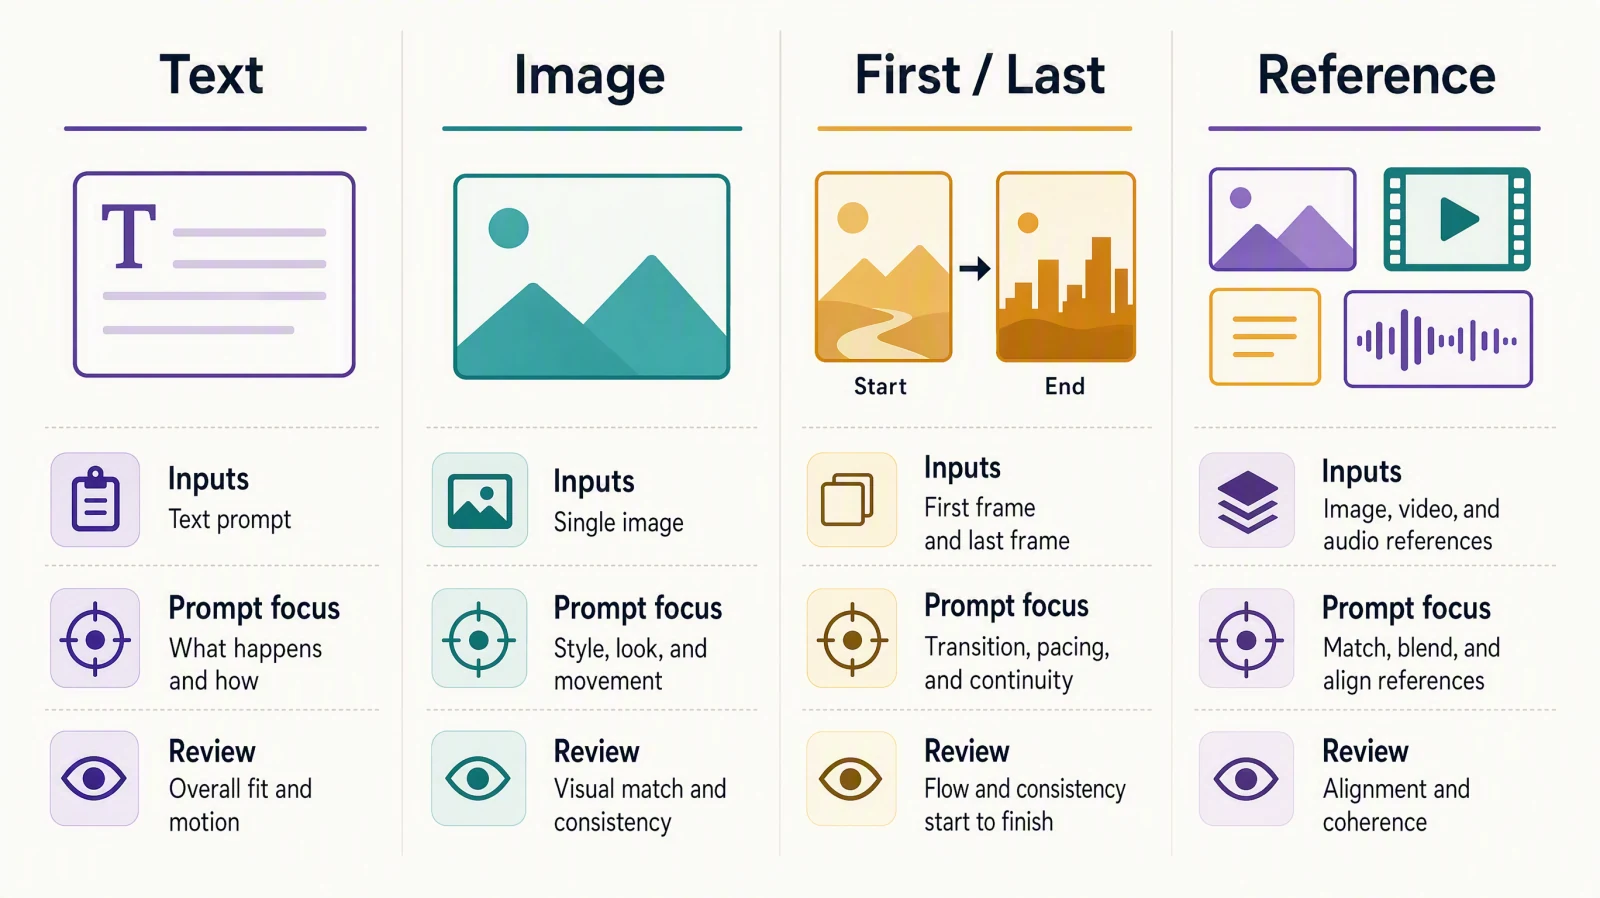
Scegli prima la modalità, poi concentra i dettagli del prompt sui campi di cui quella modalità ha più bisogno.
I marcatori dei riferimenti qui sopra seguono la documentazione dei modelli di SeedVideo AI attuale, verificata il 2 agosto 2026. Dreamina usa un'interfaccia e un sistema di etichette degli asset propri. Non dare per scontato che un'etichetta copiata da un prodotto funzioni identica in un altro. Verifica il flusso visibile prima di incollare un prompt.
Seedance 2.5: riepilogo rapido delle impostazioni
I prompt sono solo metà di una generazione. L'altra metà è il pannello delle impostazioni, e i limiti cambiano tra il generatore web di SeedVideo AI e l'API pubblica. La tabella riporta ciò che ciascuna superficie offriva l'11 ottobre 2026.
| Impostazione | Generatore web di SeedVideo AI | API di SeedVideo AI |
|---|---|---|
| Durata della clip | Da 4 a 30 secondi (5 secondi è il valore predefinito) | Da 4 a 30 secondi |
| Risoluzione | 480p, 720p o 1080p; il 1080p richiede Pro, Premium o un pacchetto di crediti, Lite arriva al massimo a 720p | 480p o 720p |
| Modalità bozza | Anteprima a 480p, poi porti a 1080p la versione da tenere; la bozza viene addebitata alla tariffa del 480p | Non disponibile |
| Proporzioni | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9, adattive | Stessi valori |
| Audio | Attivo per impostazione predefinita; disattivalo per clip mute | generate_audio |
| Input di riferimento | Fino a 9 immagini di riferimento più un video di riferimento (da 2 a 15 secondi) | Fino a 30 immagini, 10 video e 10 file audio, richiamati come @image1, @video1, @audio1 nell'ordine dell'array |
| Lunghezza del prompt | Fino a 2.500 caratteri | Fino a 2.500 caratteri |
| Tariffa in crediti | Circa 3 crediti al secondo in 480p, 6 in 720p, 15 in 1080p (tariffe base dei pacchetti di crediti; gli abbonati pagano meno al secondo) | Stesse tariffe, vedi i prezzi |
Quanto deve essere lungo un prompt dipende dalla durata della clip che hai scelto. Queste sono raccomandazioni editoriali basate sulle nostre bozze, non limiti del modello:
| Durata della clip | Momenti | Lunghezza del prompt che resta verificabile | Cosa togliere per primo se non funziona |
|---|---|---|---|
| Da 4 a 5 secondi | 1 inquadratura, 1 azione | Da 40 a 80 parole | Movimenti secondari e aggettivi di stile |
| 10 secondi | Da 1 a 2 momenti | Da 60 a 120 parole | Il secondo movimento di camera |
| 15 secondi | Da 2 a 3 momenti | Da 90 a 160 parole | I dialoghi, tieni solo l'ambiente sonoro |
| 30 secondi | 4 momenti (aggancio, sviluppo, prova, risoluzione) | Da 150 a 260 parole | I dettagli del terzo e quarto momento, tieni il finale |
I 12 esempi completi qui sotto sono scritti per la riga da 30 secondi. I 24 spunti sono pensati per le righe da 5 a 10 secondi e si possono combinare in momenti più lunghi.
Pianificare una scena da 30 secondi
Un piano in quattro momenti evita che una clip lunga diventi un'unica azione senza interruzioni:
| Momento | Intervallo indicativo | Compito | Domanda utile |
|---|---|---|---|
| Aggancio | 0-5 secondi | Presentare il soggetto e un motivo per continuare a guardare | Cosa cambia subito? |
| Sviluppo | 5-16 secondi | Mostrare l'azione principale o il problema | Cosa deve capire chi guarda? |
| Prova | 16-25 secondi | Dimostrare il risultato, la conseguenza o la svolta emotiva | Cosa rende visibile l'affermazione? |
| Risoluzione | 25-30 secondi | Tenere un finale pulito o un richiamo | Cosa deve comunicare l'ultimo fotogramma? |
Non trattare questi intervalli come punti di montaggio esatti. Sono uno strumento di scrittura. Se un momento ha bisogno di più spazio, accorciane un altro. Una dimostrazione di prodotto può dedicare quasi tutto il tempo alla prova, mentre una scena di dialogo può richiedere uno sviluppo più lungo.
Se a una clip finita servono più di 30 secondi, o se il suo ultimo momento finisce troppo presto, estendila invece di riscriverla: l'AI video extender prosegue una clip dal suo ultimo fotogramma per 4-30 secondi, e l'istruzione deve dire "extend" perché Seedance 2.5 lavori in modalità estensione.
Come abbiamo testato i 12 esempi
Il 13 ottobre 2026 abbiamo generato una volta su Seedance 2.5 ciascuno dei 12 prompt completi qui sotto, copiati parola per parola da questa guida. Ogni render ha usato l'impostazione più corta accettata dal modello: 4 secondi in 480p. È una frazione dei 30 secondi previsti da ogni prompt, quindi i fotogrammi mostrano quali momenti il modello esegue per primi e quanto tiene identità, prodotti e riferimenti. Per giudicare un finale da 30 secondi serve comunque un render a durata piena.
- Impostazioni: Seedance 2.5, 480p, 4 secondi, un render per prompt. Gli esempi testuali hanno usato le proporzioni indicate nel prompt; quelli da immagine hanno usato l'immagine sorgente come primo fotogramma con proporzioni adattive; quelli con riferimenti hanno usato gli input
@image,@videoe@audioelencati. - Audio: attivo per gli esempi con dialogo, monologo, musica e UGC (5, 7, 10, 11, 12), disattivato per gli altri. Le nostre note riguardano solo l'immagine. Non abbiamo verificato a orecchio parole pronunciate o musica.
- Input: ogni persona, foto prodotto, stanza, tavola dei costumi e fotogramma di stile è un sostituto generato con l'AI. I riferimenti di movimento sono brevi clip generate con l'AI al posto dei filmati girati in proprio citati nei prompt. Le tracce di dialogo e monologo sono voci sintetiche text-to-speech, e la musica è un loop sintetizzato originale.
- Tempo di generazione: misurato dall'invio alla clip finita per ogni render. La tua attesa varierà in base alla coda e alle impostazioni.
| # | Esempio | Modalità e input | Tempo (m:ss) | Errore principale |
|---|---|---|---|---|
| 1 | Storia di prodotto con lampada da scrivania | Testo, 16:9 | 2:22 | Ha saltato il momento dello schizzo |
| 2 | Banchina sotto la pioggia, cinematografica | Testo, 16:9 | 2:36 | Finisce al passaggio del treno, prima della decisione |
| 3 | Aggancio verticale per una ricetta | Testo, 9:16 | 2:24 | Manca l'apertura sul piatto finito; il colore dei noodles è cambiato |
| 4 | Macro di un flacone skincare | Immagine (primo fotogramma) | 4:56 | La goccia scende sul fronte dell'etichetta invece che sul lato |
| 5 | Dal ritratto al dialogo | Immagine (primo fotogramma), audio attivo | 5:30 | Nessun errore visibile nell'immagine |
| 6 | Illustrazione in movimento | Immagine (primo fotogramma) | 5:09 | Le due lampade si accendono insieme; la lancetta non si muove |
| 7 | Demo di prodotto UGC con AI | Riferimenti: 2 immagini + 1 video, 9:16 | 4:52 | È comparso un secondo contenitore |
| 8 | Dalla previsualizzazione alla scena finale | Riferimenti: 2 immagini + 1 video, 16:9 | 5:17 | I personaggi A e B si sono scambiati di posto |
| 9 | Prodotto, ambiente, stile | Riferimenti: 3 immagini + 1 video, 16:9 | 4:41 | Disposizione della cucina cambiata; caraffa copiata dalla clip di movimento |
| 10 | Dialogo tra due persone | Riferimenti: 2 immagini + 1 audio, 16:9 | 4:07 | Nessun ritorno al campo largo |
| 11 | Studio di movimento guidato dalla musica | Riferimenti: 1 immagine + 1 audio, 1:1 | 4:51 | Nessuna pausa visibile; finale non equilibrato |
| 12 | Monologo guidato dall'audio | Riferimenti: 1 immagine + 1 audio, 9:16 | 3:49 | Nessun gesto di indicazione; sul foglio bianco è comparso un disegno |
Ogni esempio qui sotto si chiude con una nota Risultato del test e con il render stesso, una clip di 4 secondi in loop senza audio. Gli esempi 3, 7 e 8 hanno anche una revisione di una riga, mostrata in prima e dopo: tre revisioni di una riga.
Esempi da testo a video
1. Storia di prodotto con lampada da scrivania
Ideale per: un concept di prodotto orizzontale quando non serve un'immagine sorgente.
Input: solo testo, 16:9. Se l'identità conta, sostituisci la lampada senza marchio con la descrizione del tuo prodotto, già autorizzata.
Prompt:
- Subject
- an unbranded matte-white desk lamp in a small apartment studio
- Action
- the room begins dim; a designer switches on the lamp, adjusts the arm, sketches, and pins the finished drawing to the wall
- Camera
- begin with a wide locked shot, move into one slow side dolly during the adjustment, then end on a steady product close-up
- Timing
- 0–4sdark-room hook
- 4–15ssetup and adjustment
- 15–25svisible drawing progress
- 25–30sclean lamp hero frame with the sketch in soft background focus
- Audio
- quiet room tone, one switch click, pencil movement, no voiceover
- Reference roles
- none
- Constraints
- one person, one lamp, consistent room layout, no logos, no on-screen text, no extra camera moves
Perché funziona: il prompt dà al prodotto un compito visibile. L'ultimo fotogramma chiude la storia invece di aggiungere una seconda funzione.
Cosa controllare: la forma della lampada, l'interazione delle mani, il percorso della camera e se l'inquadratura finale resta ferma abbastanza a lungo da essere utilizzabile.
Risultato del test (Seedance 2.5, da testo a video, 16:9, 480p, 4 secondi, audio disattivato, generato in 2 min 22 s): la lampada si accende nella stanza buia e il designer regola il braccio, quindi aggancio e preparazione sono riusciti. Non rispettato: il momento dello schizzo è stato saltato. La clip passa direttamente al disegno già appeso al muro con il braccio della lampada in primo piano, e una mano sfocata attraversa il primo piano proprio dove il prompt chiedeva un'inquadratura di prodotto ferma.
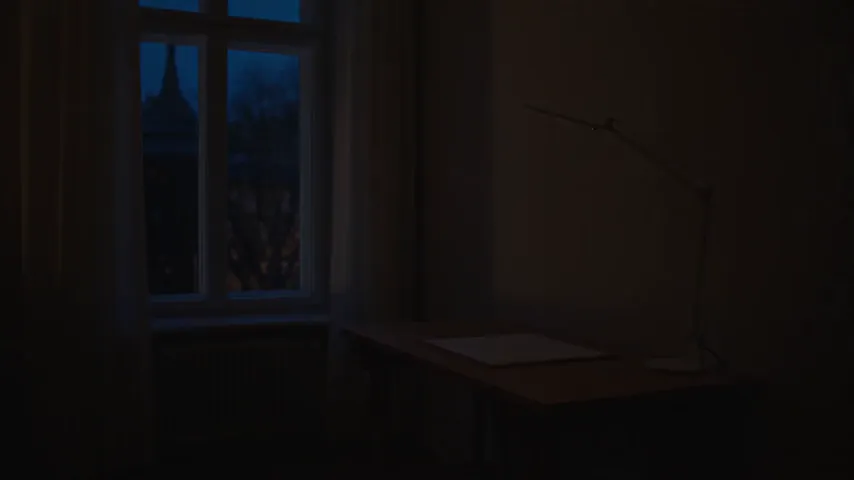
Render di prova dell'esempio 1, l'intera clip di 4 secondi (in loop): la regolazione del braccio, poi il salto allo schizzo appeso.
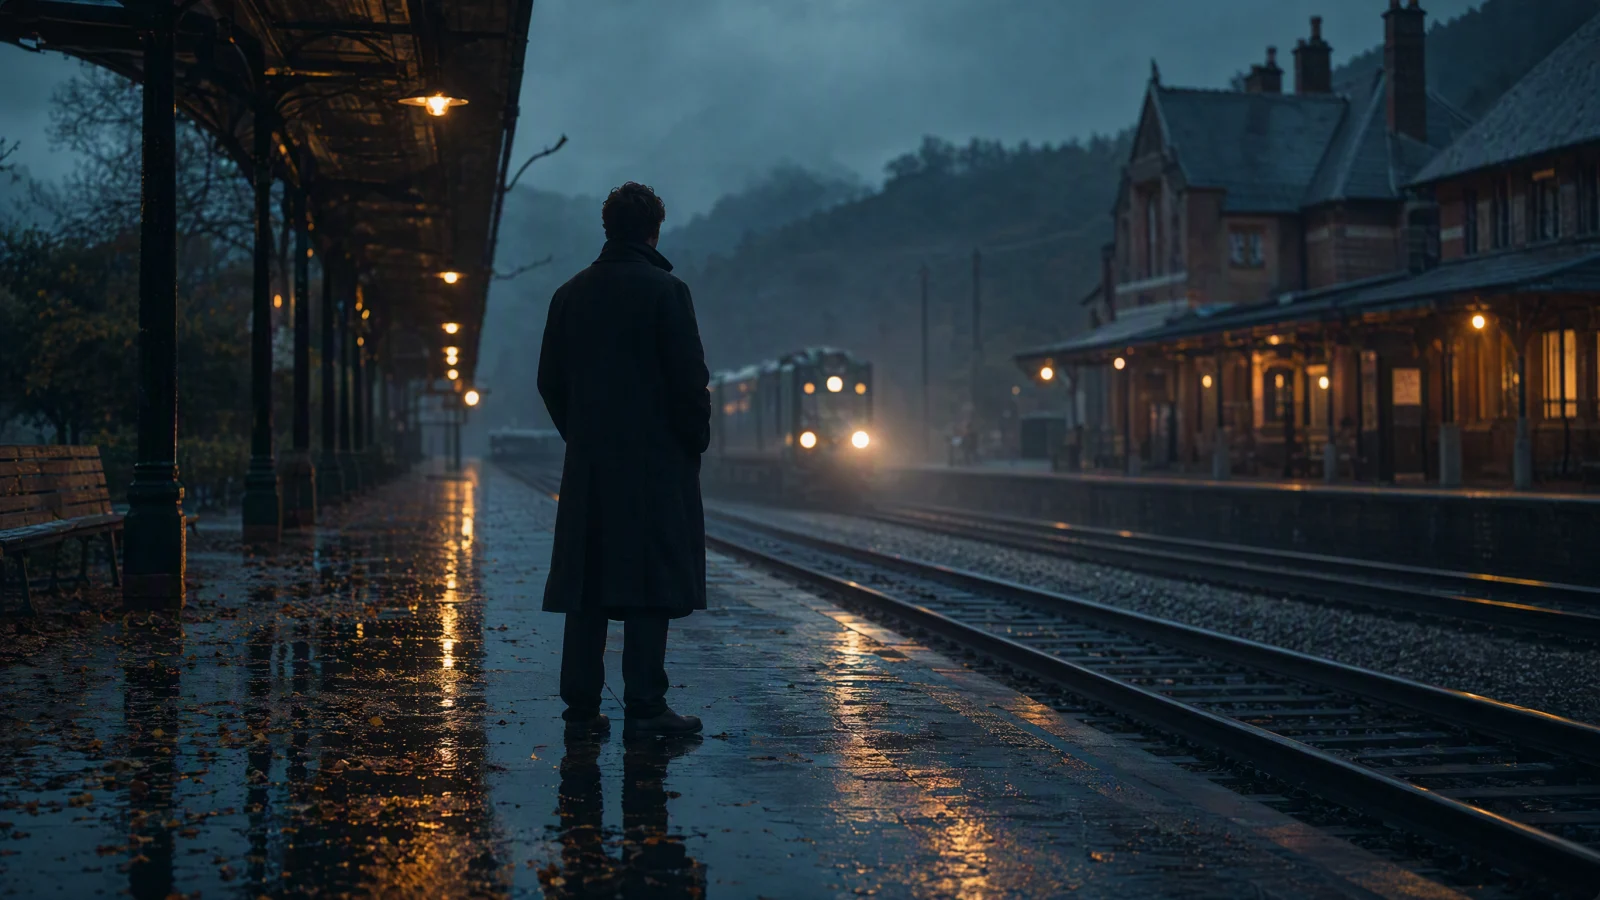
2. Scena cinematografica su una banchina sotto la pioggia
Ideale per: un test d'atmosfera da cortometraggio con un solo personaggio e una svolta visiva chiara.
Input: solo testo, 2,39:1 o 16:9.
Prompt:
- Subject
- an adult traveler in a plain dark coat waiting alone on a covered rural train platform at blue hour
- Action
- rain moves across the tracks; the traveler checks an old paper ticket, hears an approaching train, then decides not to board and folds the ticket away
- Camera
- restrained handheld medium shot, slow push toward the ticket, cut to a wide profile as the train passes, return to a still close-up
- Timing
- 0–6sestablish the empty platform
- 6–15sticket and approaching light
- 15–24strain passes without stopping in frame
- 24–30squiet decision and held close-up
- Audio
- rain, distant rail vibration, train pass, no music, no dialogue
- Reference roles
- none
- Constraints
- one traveler, no readable brand marks, no dramatic weather change, keep coat and platform lighting consistent
Perché funziona: l'azione ha un inizio, una scelta e una fine. I cambi di camera seguono la decisione invece di decorare la scena.
Cosa controllare: l'identità del viaggiatore, la direzione del treno in transito, la continuità del biglietto e la presenza di persone indesiderate sullo sfondo.
Risultato del test (Seedance 2.5, da testo a video, 16:9, 480p, 4 secondi, audio disattivato, generato in 2 min 36 s): la banchina all'ora blu, la pioggia, il controllo del biglietto e il treno in transito ci sono tutti, e cappotto e illuminazione della banchina restano coerenti. Non rispettato: la clip finisce mentre passa il treno, quindi la decisione di non salire, il biglietto ripiegato e il primo piano finale non arrivano mai. Sul biglietto di carta è comparso anche un testo stampato semi-leggibile.
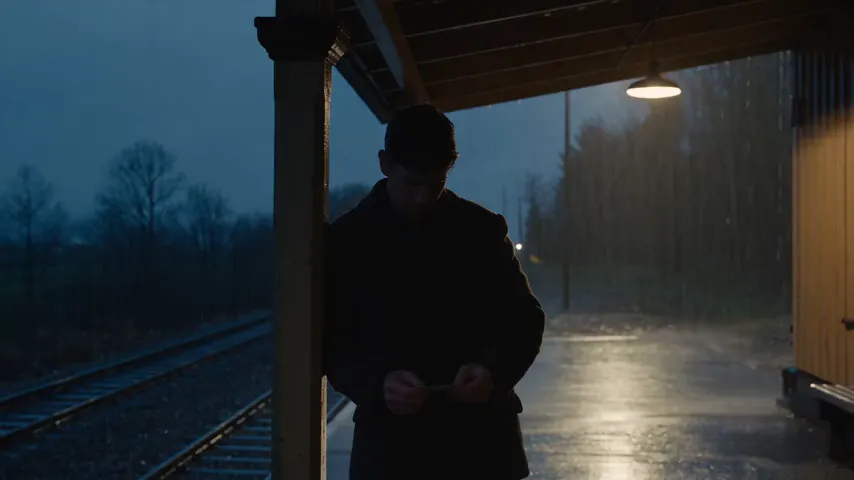
Render di prova dell'esempio 2, l'intera clip di 4 secondi (in loop): il primo piano del biglietto, poi il treno in transito con cui la clip finisce.
3. Aggancio verticale per una ricetta
Ideale per: una clip social 9:16 costruita attorno a un rapido colpo d'occhio finale.
Input: solo testo, 9:16.
Prompt:
- Subject
- a home cook making a bright citrus noodle bowl in a clean kitchen, using generic unbranded ingredients
- Action
- open on the finished bowl, rewind the visual idea into preparation, toss the noodles, then return to the finished bowl with steam and a lifted bite
- Camera
- overhead hook, two fast close inserts for zest and sauce, medium side shot for the toss, locked close-up for the ending
- Timing
- 0–3sfinal-dish hook
- 3–13singredient actions
- 13–23stoss and texture
- 23–30splated result and lifted bite
- Audio
- crisp kitchen sounds with a light rhythmic pulse, no spoken recipe and no generated captions
- Reference roles
- none
- Constraints
- one bowl, stable ingredient colors, safe utensil handling, no labels, no impossible food transformations
Perché funziona: il prompt è adatto a un feed verticale e arriva subito al punto. Ogni cambio di camera ha un soggetto chiaro.
Cosa controllare: la continuità del cibo, l'anatomia delle mani, se la ciotola d'apertura e quella finale coincidono e se gli inserti rapidi restano leggibili su uno smartphone.
Risultato del test (Seedance 2.5, da testo a video, 9:16, 480p, 4 secondi, audio disattivato, generato in 2 min 24 s): cucina pulita, una sola ciotola e un boccone sollevato alla fine. Non rispettato: la clip si apre su noodles crudi con carote ed erbe non mescolate invece che sulla ciotola finita, i noodles non vengono saltati e nell'ultimo fotogramma sono diventati arancioni, con un pezzo arancione sulle bacchette, il che viola "stable ingredient colors". Riscrivere solo la riga Timing per 4 secondi ha sistemato apertura e colore. Trovi le due versioni a confronto nella revisione 1.
Esempi da immagine a video
4. Macro di un flacone skincare
Ideale per: il movimento di un prodotto quando un'unica foto approvata deve definirne l'aspetto.
Input: un'immagine del tuo prodotto su sfondo neutro, 16:9.
Prompt:
- Subject
- preserve the bottle shape, cap, label placement, color, and proportions from the source image
- Action
- soft condensation forms on the bottle; one drop travels down the side while a leaf shadow moves slowly across the background
- Camera
- start at a medium product shot, make one slow macro push toward the drop, then settle on the full bottle
- Timing
- 0–5simmediate texture hook
- 5–18scontrolled push and moving shadow
- 18–25sdrop reaches the base
- 25–30sfull pack shot
- Audio
- faint room tone and a soft water detail, no speech
- Reference roles
- the source image controls product identity and composition
- Constraints
- keep label text unchanged, no cap movement, no duplicate bottle, no added claims, no floating particles
Perché funziona: il movimento è limitato a condensa, ombra e camera. Il riferimento del prodotto ha un solo compito esplicito.
Cosa controllare: confronta la geometria del flacone e la posizione dell'etichetta con la sorgente. Scarta qualsiasi affermazione inventata o lettera deformata.
Risultato del test (Seedance 2.5, da immagine a video con la sorgente come primo fotogramma, proporzioni adattive, 480p, 4 secondi, audio disattivato, generato in 4 min 56 s): il risultato più fedele dei dodici. Forma del flacone, tappo ed etichetta "SERUM" restano uguali per tutta la clip, con un lento avvicinamento e la condensa che si forma. Non rispettato: la goccia scende sul fronte dell'etichetta invece che sul lato del flacone, e l'ombra della foglia arriva solo nella seconda metà.
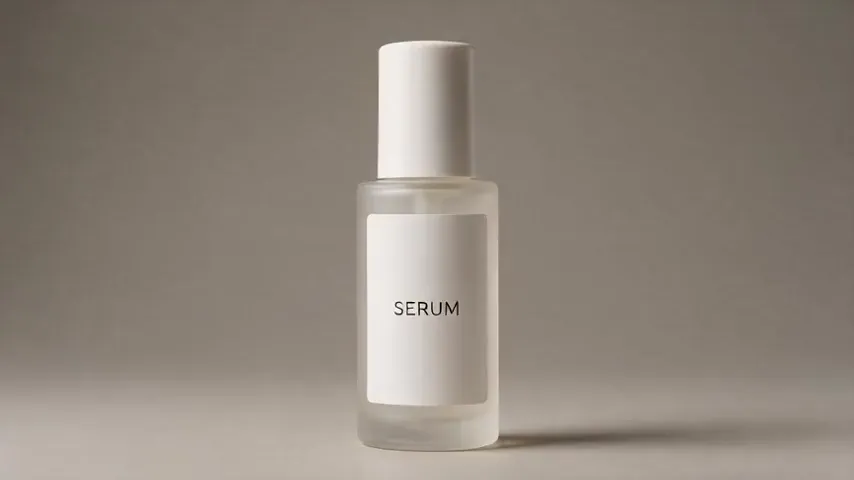
Render di prova dell'esempio 4, l'intera clip di 4 secondi (in loop): etichetta e forma del flacone corrispondono ancora all'immagine sorgente a metà e alla fine.
5. Dal ritratto al dialogo
Ideale per: un test di personaggio quando un ritratto con consenso ne definisce l'aspetto.
Input: un ritratto di una persona adulta che ha dato il consenso, con sfondo semplice, 16:9.
Prompt:
- Subject
- preserve the adult subject's facial features, hairstyle, plain blue shirt, and age from the source portrait
- Action
- the subject looks off camera, listens, turns back, and says, "I kept the original because the small mistake made it feel honest."
- Camera
- stable medium close-up with a very slow push after the subject turns back
- Timing
- 0–7slistening reaction
- 7–13sturn
- 13–24sdialogue
- 24–30squiet breath and held expression
- Audio
- natural indoor room tone, clear adult voice, no music
- Reference roles
- the image controls identity and wardrobe
- Constraints
- one speaker, no beauty retouching, no subtitles, no change of background, keep lip movement aligned with the short line
Perché funziona: la battuta è abbastanza breve da lasciare spazio all'ascolto e alla reazione. Il prompt non sovraccarica l'immagine con una nuova ambientazione.
Cosa controllare: l'ambito del consenso, l'identità del volto, il movimento della bocca, la direzione dello sguardo e se la voce è adatta alla persona che ha dato l'approvazione.
Risultato del test (Seedance 2.5, da immagine a video con la sorgente come primo fotogramma, proporzioni adattive, 480p, 4 secondi, audio attivo, generato in 5 min 30 s): volto, acconciatura, camicia blu e sfondo restano invariati, e il soggetto guarda fuori campo e si rigira come previsto. Non rispettato: nulla di visibile nell'immagine. Le labbra si muovono, ma non abbiamo verificato a orecchio la battuta pronunciata, quindi considera il dialogo non verificato.
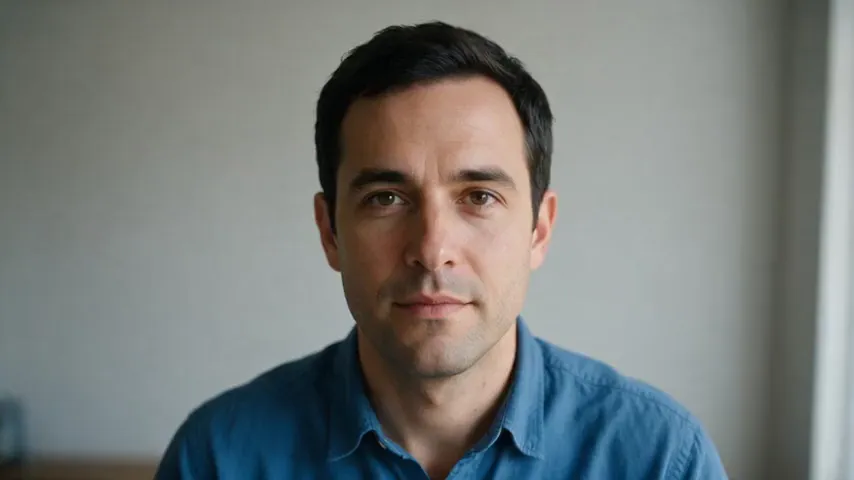
Render di prova dell'esempio 5, l'intera clip di 4 secondi (in loop, senza audio): lo sguardo altrove e il ritorno verso la camera, con identità e abiti mantenuti.
6. Un'illustrazione in movimento discreto
Ideale per: animare un'illustrazione editoriale di tua proprietà senza cambiarne la composizione.
Input: un'illustrazione originale di una biblioteca di notte, 4:5 o 16:9.
Prompt:
- Subject
- preserve the illustrated night library, its limited blue-and-amber palette, two reading figures, and paper-cut texture
- Action
- desk lamps glow on one by one, pages turn, rain traces the windows, and the clock hand advances slightly
- Camera
- nearly locked frame with a slow two-percent push toward the center table
- Timing
- 0–6sfirst lamp glow
- 6–19spage and rain movement
- 19–25ssecond lamp glow
- 25–30ssettle into the original composition
- Audio
- soft rain and page turns, no dialogue, no melody
- Reference roles
- the image controls composition, characters, palette, and medium
- Constraints
- preserve the illustration style, no extra readers, no realistic faces, no camera orbit, no new text on book covers
Perché funziona: i piccoli movimenti rispettano l'illustrazione di partenza. Tornare alla composizione originale dà al loop un finale utilizzabile.
Cosa controllare: cerca derive di stile, realismo involontario, oggetti nuovi, mani deformate e qualsiasi movimento che rompa l'effetto carta ritagliata.
Risultato del test (Seedance 2.5, da immagine a video con la sorgente come primo fotogramma, proporzioni adattive, 480p, 4 secondi, audio disattivato, generato in 5 min 9 s): lo stile a carta ritagliata, la palette blu e ambra e la composizione restano invariati, e le lampade da scrivania si accendono. Non rispettato: le due lampade si accendono quasi insieme invece che una alla volta, la lancetta dell'orologio non si muove in modo visibile e l'avvicinamento si nota appena.
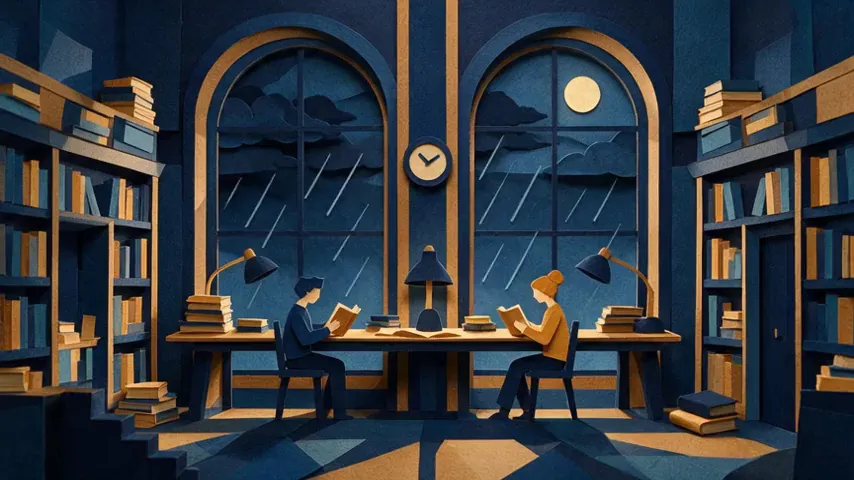
Render di prova dell'esempio 6, l'intera clip di 4 secondi (in loop): stile e composizione invariati, lampade accese.
Esempi da riferimenti a video
7. Dimostrazione di prodotto UGC con AI
Ideale per: una dimostrazione verticale in stile creator, con riferimenti separati per identità e prodotto.
Input: @image1 presentatore adulto che ha dato il consenso; @image2 foto del tuo prodotto; @video1 dimostrazione delle mani girata in proprio; 9:16.
Prompt:
- Subject
- @image1 defines the presenter. @image2 defines the unaltered product. @video1 defines only the hand motion and order of use
- Action
- the presenter opens with the product already in hand, demonstrates the three physical steps from @video1, then shows the unchanged product beside the completed result
- Camera
- phone-like medium close-up, one top-down insert for the demonstration, return to the same medium close-up
- Timing
- 0–4svisual hook
- 4–18sdemonstration
- 18–25sresult
- 25–30sproduct and result held together
- Audio
- natural spoken line, "Here is the part I kept getting wrong," followed by direct demonstration sound; no music
- Reference roles
- @image1 identity and wardrobe; @image2 product identity; @video1 motion only
- Constraints
- do not copy the background, person, or product visible in @video1; no claims, price, logo changes, or captions
Perché funziona: ogni asset ha un solo compito, così il riferimento di movimento non entra in competizione con l'identità del presentatore o del prodotto.
Cosa controllare: se il risultato prende in prestito dettagli indesiderati dal video di movimento, e se il prodotto resta invariato durante l'inserto.
Risultato del test (Seedance 2.5, da riferimenti a video con 2 immagini e 1 video, 9:16, 480p, 4 secondi, audio attivo, generato in 4 min 52 s): l'apertura a mano libera, l'inserto dall'alto e il riempimento e la chiusura del contenitore seguono tutti @video1. Non rispettato: la clip finisce sull'inquadratura dall'alto invece di tornare al mezzo primo piano, e nell'ultimo fotogramma compare un secondo contenitore, piegato. Una riga di vincoli non l'ha risolto, perché la causa stava nell'immagine di riferimento. Vedi la revisione 2.
8. Dalla previsualizzazione alla scena finale
Ideale per: trasformare una prova di blocking girata in proprio in una scena più rifinita, senza copiare scenografie protette.
Input: @video1 prova girata in proprio con due interpreti adulti; @image1 foto originale della location; @image2 tavola originale dei costumi; 16:9.
Prompt:
- Subject
- two adult characters follow the positions and movement timing in @video1. @image2 defines their simple approved wardrobe
- Action
- character A crosses to the window, character B waits by the table, then both react to a light outside
- Camera
- preserve the basic blocking from @video1, but use a slow lateral dolly instead of the rehearsal's static camera
- Timing
- 0–7sroom and positions
- 7–18scrossing action
- 18–25sshared reaction
- 25–30shold both characters in profile
- Audio
- room tone, two footsteps, distant vehicle sound, no dialogue
- Reference roles
- @video1 movement and timing; @image1 environment and light direction; @image2 wardrobe
- Constraints
- do not preserve faces, props, or background from @video1; no extra characters, no recognizable franchise design
Perché funziona: la prova fornisce il blocking, mentre le immagini approvate sostituiscono i dettagli visivi provvisori. Il movimento di camera finale è indicato a parte.
Cosa controllare: verifica che il modello segua le posizioni senza importare volti od oggetti di scena della prova. Controlla la direzione di sguardo e movimento e la reazione condivisa.
Risultato del test (Seedance 2.5, da riferimenti a video con 2 immagini e 1 video, 16:9, 480p, 4 secondi, audio disattivato, generato in 5 min 17 s): vengono usati la stanza di @image1 ed entrambi gli outfit di @image2, e nessun volto della prova è passato da @video1. Non rispettato: A e B si sono scambiati i compiti. Il personaggio B con la sopracamicia senape va alla finestra mentre il personaggio A con il maglione antracite resta vicino al tavolo, ricalcando il percorso dell'interprete a destra in @video1. Non c'è alcun carrello laterale. Legare ogni personaggio a un outfit ha corretto il blocking. Vedi la revisione 3.
9. Mappa di prodotto, ambiente e stile
Ideale per: una scena e-commerce controllata che usa più riferimenti visivi approvati.
Input: @image1 il tuo prodotto; @image2 la tua cucina come location; @image3 tavola colori originale; @video1 movimento di versata girato in proprio; 16:9.
Prompt:
- Subject
- @image1 defines the exact reusable bottle. @image2 defines the kitchen layout. @image3 defines only the warm neutral color treatment
- Action
- a hand fills the bottle using the smooth pouring speed from @video1, closes it, places it beside a lunch bag, then carries both out of frame
- Camera
- one waist-level tracking shot with a brief close insert during the pour, then return to the original axis
- Timing
- 0–5sempty bottle hook
- 5–17sfill and close
- 17–24spack
- 24–30sclean exit and empty counter
- Audio
- water, cap click, fabric movement, no speech
- Reference roles
- @image1 product identity; @image2 environment; @image3 color only; @video1 motion only
- Constraints
- do not copy objects from the color board or background from the motion clip; no label mutation, no duplicate hands, no text overlays
Perché funziona: la mappa dei riferimenti impedisce che una tavola di stile diventi la pianta della scena. Il piano di lavoro vuoto alla fine dà alla sequenza una risoluzione chiara.
Cosa controllare: l'identità del prodotto, il numero di mani, il livello di riempimento, la continuità dell'asse di camera e se dettagli dei riferimenti finiscono nel ruolo sbagliato.
Risultato del test (Seedance 2.5, da riferimenti a video con 3 immagini e 1 video, 16:9, 480p, 4 secondi, audio disattivato, generato in 4 min 41 s): la borraccia, il trattamento cromatico caldo e neutro e il piano di lavoro vuoto alla fine corrispondono. Non rispettato: la cucina non segue @image2 (finestra e disposizione dei mobili sono cambiate), e l'acqua viene versata dalla caraffa di vetro di @video1, un oggetto trapelato dal riferimento di movimento. A metà clip non si vede nessuna mano.
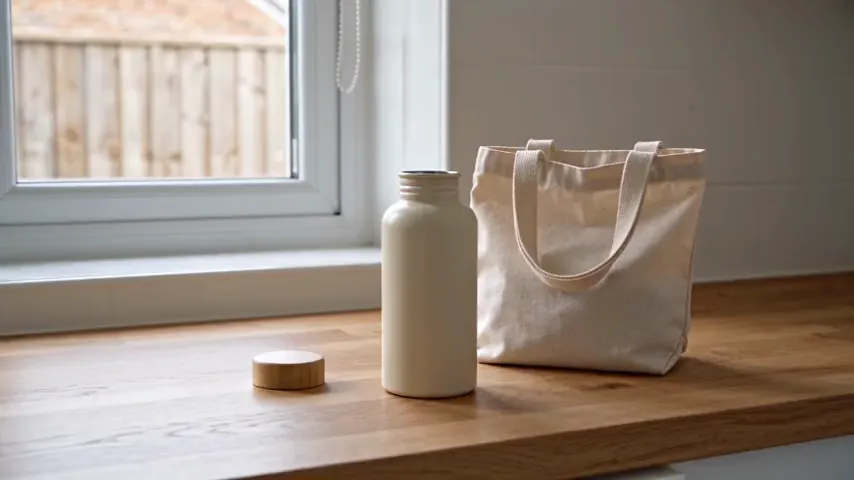
Render di prova dell'esempio 9, l'intera clip di 4 secondi (in loop): prodotto e palette corrispondono; la caraffa di vetro viene dalla clip di movimento.
Esempi con audio e dialoghi
10. Dialogo tra due persone con un momento di reazione
Ideale per: una breve scena di dialogo con riferimenti di personaggio e di voce per cui c'è il consenso.
Input: @image1 e @image2 riferimenti di personaggi adulti che hanno dato il consenso; @audio1 dialogo provvisorio approvato; 16:9.
Prompt:
- Subject
- @image1 is speaker A in a gray sweater. @image2 is speaker B in a green jacket. Keep their positions and appearance consistent
- Action
- A asks, "Did you move the chair?" B looks at the empty corner, pauses, and answers, "No."
- Camera
- begin in a two-shot, cut to B only after the question, then return to a wider two-shot for the empty-corner reveal
- Timing
- 0–7sroom setup
- 7–13squestion
- 13–21slook and pause
- 21–25sanswer
- 25–30ssilent wide reveal
- Audio
- @audio1 controls the words and pause length; retain quiet room tone and one floor creak
- Reference roles
- @image1 and @image2 identity; @audio1 dialogue timing only
- Constraints
- two adults only, no extra speech, no subtitles, no voice imitation beyond the approved recording, keep eyelines consistent
Perché funziona: la pausa viene trattata come parte della recitazione. La camera aspetta la domanda prima di isolare la reazione.
Cosa controllare: l'assegnazione delle battute, il movimento delle labbra, la durata della pausa, le linee di sguardo e se il campo largo finale rende chiaro l'angolo vuoto.
Risultato del test (Seedance 2.5, da riferimenti a video con 2 immagini e 1 audio, 16:9, 480p, 4 secondi, audio attivo, generato in 4 min 7 s): entrambi i personaggi mantengono identità e abiti, il maglione grigio e la giacca verde, e lo stacco dall'inquadratura a due su B, sopra la spalla di A, avviene come previsto. Non rispettato: non c'è il ritorno al campo largo per rivelare l'angolo vuoto. Abbiamo controllato solo l'immagine, non il dialogo né la durata della pausa.
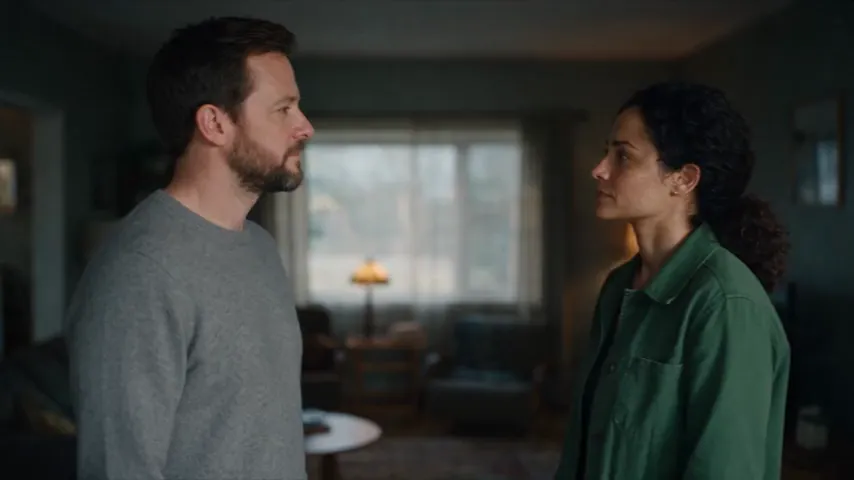
Render di prova dell'esempio 10, l'intera clip di 4 secondi (in loop, senza audio): l'inquadratura a due e lo stacco su B; la clip finisce prima della rivelazione in campo largo.
11. Studio di movimento guidato dalla musica
Ideale per: un test ritmico astratto, con diritti verificati, senza testi cantati né immagini di marca.
Input: @audio1 loop strumentale originale di 30 secondi; @image1 fotogramma di stile geometrico originale; 1:1 o 9:16.
Prompt:
- Subject
- three simple paper forms use the color and texture rules from @image1
- Action
- forms fold on the main pulse, slide on the syncopated notes, pause during the brief break, then assemble into one balanced composition
- Camera
- fixed frontal view with one slow push during the final eight seconds
- Timing
- follow the broad sections of @audio1: opening pulse, denser middle phrase, short break, final resolve
- Audio
- @audio1 is the only soundtrack. Do not add vocals or sound effects
- Reference roles
- @audio1 rhythm and section changes; @image1 material and palette only
- Constraints
- no logos, letters, faces, or exact imitation of an existing music video; keep the forms readable against the background
Perché funziona: il prompt associa il movimento alle sezioni musicali invece di pretendere un taglio su ogni battito. Così resta spazio per forme leggibili.
Cosa controllare: se il movimento risponde ai cambi principali, se la pausa è visibile e se la composizione finale regge.
Risultato del test (Seedance 2.5, da riferimenti a video con 1 immagine e 1 audio, 1:1, 480p, 4 secondi, audio attivo, generato in 4 min 51 s): il materiale cartaceo e la palette corallo, verde acqua e senape seguono @image1, e le forme si piegano e si uniscono. Non rispettato: 4 secondi coprono solo l'inizio del loop da 30 secondi, quindi non c'è una pausa visibile, e il finale è un ammasso di forme sovrapposte invece di una composizione equilibrata.
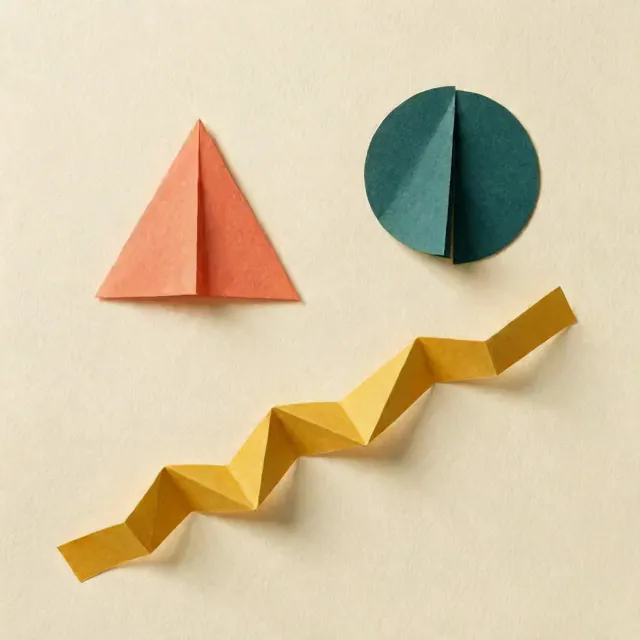
Render di prova dell'esempio 11, l'intera clip di 4 secondi (in loop, senza audio): materiale e palette dal fotogramma di stile, con un finale ad ammasso.
12. Monologo verticale guidato dall'audio
Ideale per: un video esplicativo per i social con una sola persona che parla, che ha dato il consenso, e una registrazione approvata.
Input: @image1 persona adulta che parla e ha dato il consenso; @audio1 registrazione vocale originale di 22 secondi; 9:16.
Prompt:
- Subject
- @image1 defines the adult speaker, plain clothing, and neutral home-office setting
- Action
- the speaker delivers @audio1, points once to a blank paper sketch, then returns attention to camera and ends with a small nod
- Camera
- stable chest-up phone framing, one subtle push during the main point, no cuts
- Timing
- 0–3sattentive silent opening
- 3–25sapproved recording
- 25–30snod and clean hold
- Audio
- @audio1 controls the spoken words and pacing; preserve light room tone, no music
- Reference roles
- @image1 identity and environment; @audio1 speech only
- Constraints
- no generated captions, no additional claims, no background changes, no voice cloning beyond the speaker's explicit permission
Perché funziona: l'azione visiva resta abbastanza semplice da sostenere il parlato. L'apertura e il finale silenziosi lasciano margine per i tagli in montaggio.
Cosa controllare: la sincronizzazione labiale, il testo approvato, l'anatomia delle mani, il contatto visivo e se il finale resta fermo.
Risultato del test (Seedance 2.5, da riferimenti a video con 1 immagine e 1 audio, 9:16, 480p, 4 secondi, audio attivo, generato in 3 min 49 s): identità, T-shirt blu navy e sfondo dello studio in casa restano invariati, e a metà clip la persona sta parlando. Non rispettato: non c'è il gesto di indicazione, e sul foglio bianco di @image1 è comparso un quadrato disegnato fin dal primo fotogramma. Non abbiamo verificato a orecchio le parole pronunciate.
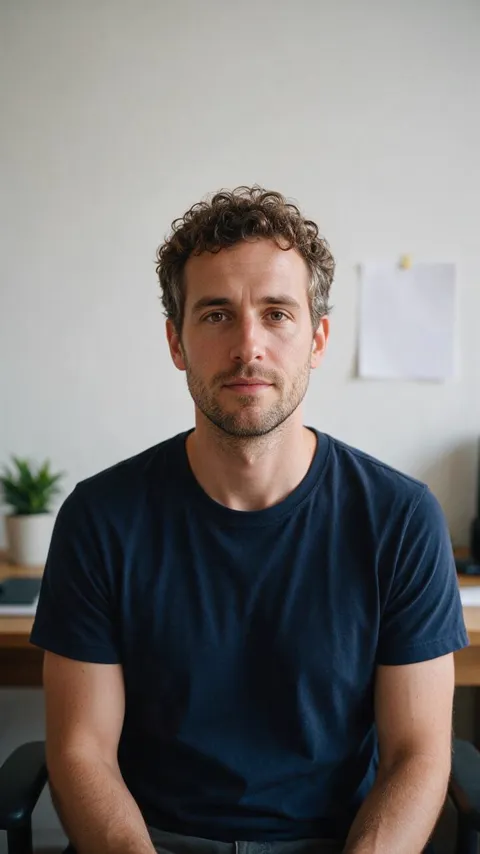
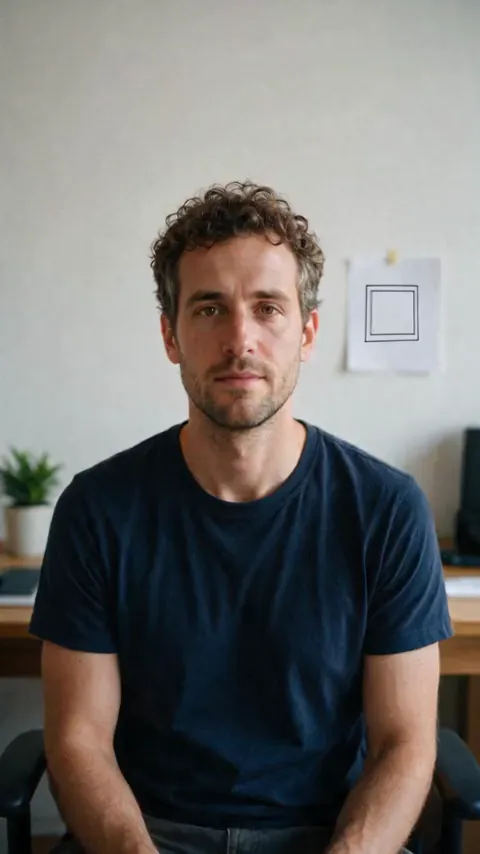
Esempio 12: l'immagine di riferimento (a sinistra), poi il render completo di 4 secondi (a destra, in loop, senza audio). Il foglio bianco è diventato uno schizzo.
Scrivi il Timing per la durata che generi
Lo schema più chiaro emerso dai 12 render di prova: quando un prompt pianifica quattro momenti in 30 secondi e la clip dura solo 4 secondi, Seedance 2.5 spende il tempo sul primo o sui primi due momenti e lascia cadere il resto. La clip della banchina sotto la pioggia è finita al passaggio del treno, prima della decisione del viaggiatore. La demo UGC non è mai tornata al mezzo primo piano finale, la scena di dialogo non è mai arrivata alla rivelazione in campo largo e lo studio musicale non ha mai mostrato la sua pausa. Il modello non ha compresso i quattro momenti in 4 secondi: ha eseguito l'apertura e si è fermato.
Nel nostro test, riscrivere la riga Timing per la durata reale ha risolto il problema. Nella revisione 1 il prompt della ricetta ha mantenuto tutti gli altri campi e ha sostituito la riga Timing da 30 secondi con una da 4 secondi. Sono comparsi sia l'apertura sulla ciotola finita sia il boccone sollevato alla fine. Per la sintassi dei momenti secondo per secondo e cinque modelli pronti all'uso, vedi Seedance 2.5 timestamp prompts.
| Durata della clip che generi | Schema della riga Timing | Cosa tenere |
|---|---|---|
| Da 4 a 5 secondi | 0-1s hook; 1-3s one action; 3-4s held ending | Un'azione e il fotogramma finale |
| 10 secondi | 0-2s hook; 2-7s main action; 7-10s result and hold | Due momenti, finale tenuto per 2 secondi |
| 15 secondi | 0-3s hook; 3-9s action; 9-13s result; 13-15s hold | Tre momenti, un movimento di camera |
| 30 secondi | 0-5s hook; 5-16s development; 16-25s proof; 25-30s ending | Quattro momenti, come negli esempi completi |
Questi schemi sono nostre raccomandazioni ricavate dai render di prova, non controlli documentati del modello. Se fai una bozza di un'idea da 30 secondi a 4 o 5 secondi per risparmiare crediti, riscrivi prima la riga Timing. Altrimenti la bozza ti dice qualcosa solo sull'apertura, e il finale resta da testare fino al render a durata piena.
Mappa dei ruoli dei riferimenti
Dai a ogni asset un compito principale:
| Ruolo | Cosa può controllare il riferimento | Cosa non dovrebbe controllare per sbaglio |
|---|---|---|
| Identità | Volto, abiti, geometria del prodotto | Percorso della camera o oggetti di sfondo non correlati |
| Prodotto | Forma, materiale, posizione dell'etichetta | Aspetto del presentatore o disposizione della stanza |
| Ambiente | Architettura, direzione della luce, disposizione dello spazio | Identità del personaggio o design del prodotto |
| Movimento | Blocking, ordine dei gesti, velocità | Volti, costumi, oggetti di scena provvisori della prova |
| Stile | Palette, tecnica, texture, contrasto | Composizione esatta o design di personaggi protetti |
| Audio | Parole, ritmo, ambiente sonoro, durata delle pause | Identità visiva, a meno che non sia assegnata esplicitamente |
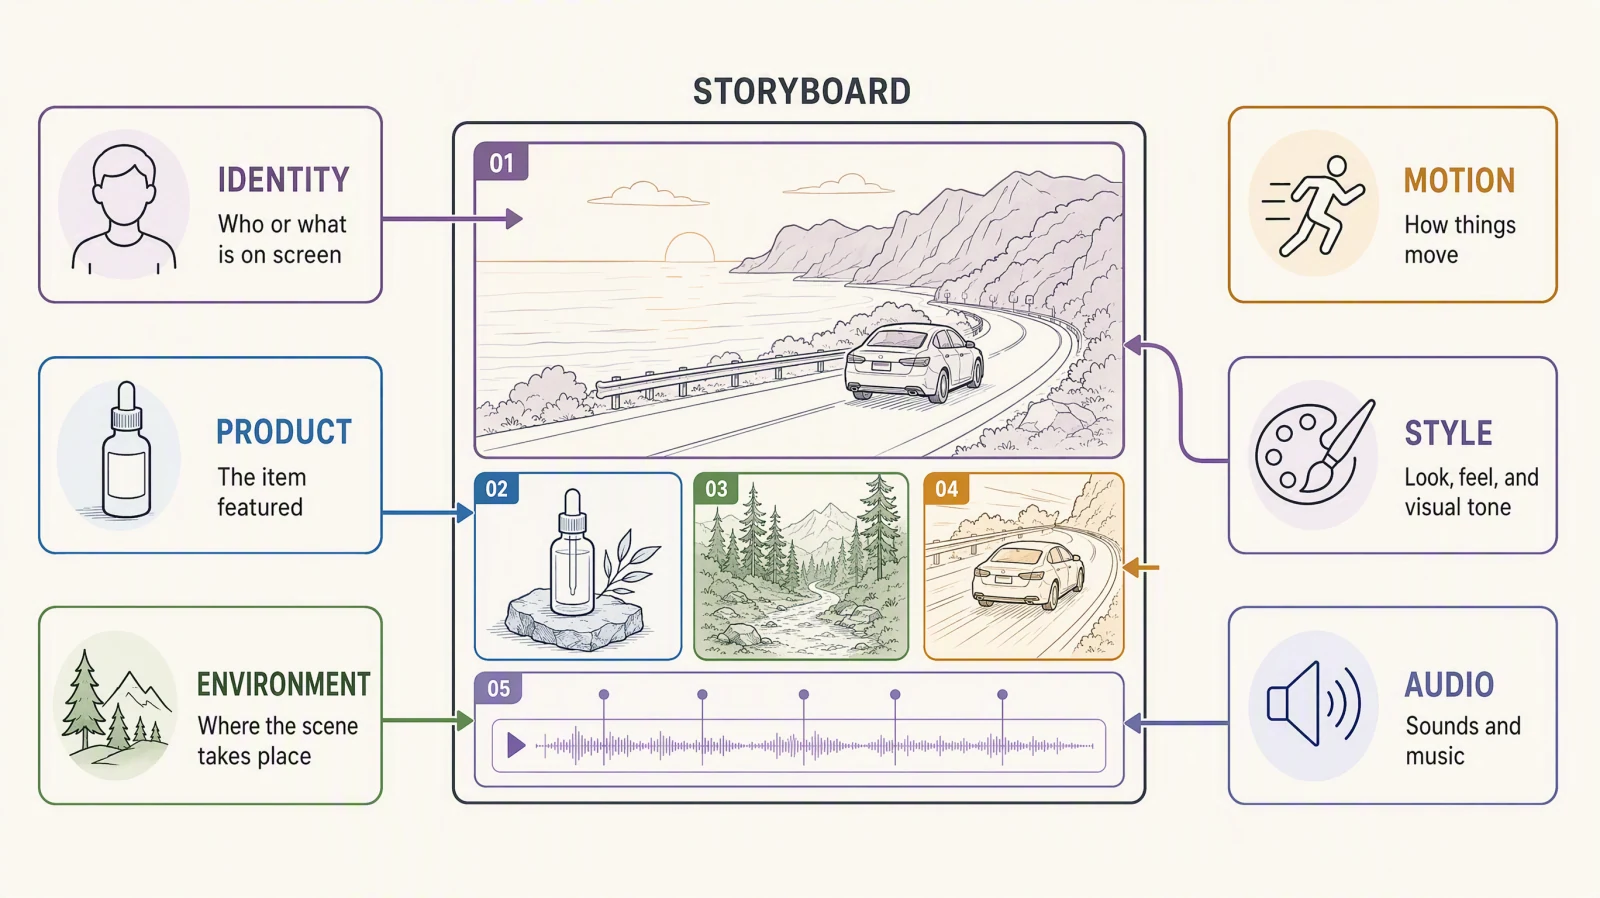
Ruoli chiari per i riferimenti riducono i prestiti accidentali dall'asset sbagliato.
Se due immagini definiscono entrambe il prodotto, scegline una come riferimento principale. Se un video di prova contiene volti o oggetti provvisori, specifica che controlla solo il movimento. Un pacchetto di riferimenti diventa più difficile da diagnosticare quando ogni file può influenzare tutto.
Prompt per Seedance 2.5: 24 spunti brevi da copiare
I dodici esempi qui sopra sono brief completi da 30 secondi. Questi 24 spunti sono la versione breve: un paragrafo ciascuno, scritto con lo stesso spirito a sette campi, dimensionato per bozze da 5 a 15 secondi. I prompt restano in inglese, così come li abbiamo scritti e testati. Incollane uno, genera, poi trasforma quello che funziona in un brief temporizzato. Ogni blocco ha un link "Try this prompt" che lo apre nel generatore.
Spunti per prodotti
- Subject
- an unbranded amber glass serum bottle on wet black slate
- Action
- the bottle stays still while a single water drop slides down the label
- Camera
- locked macro, then a two-second push-in at the end
- Audio
- quiet room tone, one soft drip
- Constraints
- label geometry unchanged, no hands, no text, no extra props
- Subject
- a pair of unbranded white leather sneakers on a concrete floor in a bright studio
- Action
- the sneakers rotate a quarter turn as soft light sweeps across the toe box
- Camera
- low locked shot at floor level
- Audio
- none
- Constraints
- stitching and sole shape identical throughout, no logos, single light sweep only
- Subject
- a matte-black insulated bottle on a mossy rock beside a mountain stream
- Action
- condensation forms on the bottle while the stream moves behind it
- Camera
- slow half orbit ending front-on
- Audio
- running water, light wind, no music
- Constraints
- bottle proportions fixed, no people, no on-screen text
- Subject
- a folded linen shirt on a warm wooden table
- Action
- the shirt unfolds itself flat, sleeves last
- Camera
- locked overhead
- Audio
- soft fabric sound only
- Constraints
- color and weave consistent, no hands, ends on the flat hero frame held for two seconds
Spunti cinematografici
- Subject
- a lone lighthouse keeper in a wool coat on a stone stairway at dusk
- Action
- he climbs three steps, stops, and looks up as the lamp turns on above him
- Camera
- low angle, slow tilt up with the light
- Audio
- wind and distant waves, no dialogue
- Constraints
- one person, coat and face consistent, no extra light sources
- Subject
- an empty 1970s diner at night, rain on the windows
- Action
- neon sign flickers on, coffee steam rises from a single cup at the counter
- Camera
- slow dolly along the counter
- Audio
- rain, faint neon hum, no music
- Constraints
- no people enter, sign text unreadable, interior layout fixed
- Subject
- a young woman in a red raincoat at a bus stop in fog
- Action
- headlights approach, she steps forward, then the light passes without stopping
- Camera
- side profile medium shot, static
- Audio
- engine passing, wet tires, no dialogue
- Constraints
- coat color constant, no readable signs, fog density steady
- Subject
- a desert road at golden hour with one vintage motorcycle parked on the shoulder
- Action
- dust drifts across the road as the sun drops behind a ridge
- Camera
- wide locked shot, slow natural light change
- Audio
- wind only
- Constraints
- no rider, no vehicles, ridge silhouette unchanged
Spunti verticali per i social (9:16)
- Subject
- vertical 9:16, a hand places a fresh croissant on a white plate
- Action
- the croissant is torn open to show layers with a small puff of steam
- Camera
- locked close-up, phone-friendly framing
- Audio
- crisp crackle, no voice
- Constraints
- one croissant, clean background, headroom for a caption
- Subject
- vertical 9:16, a person in a plain hoodie holds a small potted plant up to the camera
- Action
- they turn the pot to show a new leaf, then smile
- Camera
- static selfie framing
- Audio
- room tone
- Constraints
- face consistent, centered subject, headroom for a caption, no text
- Subject
- vertical 9:16, a bowl of ramen on a dark counter
- Action
- chopsticks lift noodles in slow motion, steam rising
- Camera
- tight locked shot at a slight angle
- Audio
- gentle broth sound
- Constraints
- bowl and toppings unchanged, no text, ends on the lifted noodles
- Subject
- vertical 9:16, a runner ties her shoes on a track at sunrise
- Action
- she stands, exhales, and starts a three-step sprint out of frame
- Camera
- low static shot
- Audio
- breath and footsteps
- Constraints
- outfit consistent, no other runners, sun position fixed
Spunti da immagine a video
Preserve the uploaded portrait exactly: face, hair, clothing, and framing. Add a slow blink, a small breath, and hair moving in a light breeze. Camera: static. Audio: none. Constraints: no change to identity, background, or lighting; motion stays subtle.
Preserve the uploaded product photo. Rotate the product 30 degrees on its base while the highlight travels across it. Camera: locked. Audio: none. Constraints: label and geometry unchanged, background unchanged, no added objects.
Preserve the uploaded landscape illustration. Add parallax: foreground trees drift slightly faster than the mountains, clouds move slowly. Camera: gentle lateral slide. Audio: soft wind. Constraints: colors and line style unchanged, no new elements.
Preserve the uploaded interior photo. Move the camera forward through the room toward the window over the full clip. Audio: quiet ambience. Constraints: furniture positions and materials stay identical, no people, exposure steady.
Spunti da riferimenti a video
Use @image1 for the character's face, hair, and outfit. Use @image2 for the environment only. Action: the character walks to the window and opens it. Camera: slow follow from behind. Audio: street noise rises as the window opens. Constraints: identity from @image1 wins over any figure in @image2; no extra people.
Use @image1 for the product and @video1 for the camera move and timing. Action: reproduce the orbit and final stop from @video1 with the product from @image1. Audio: none. Constraints: product geometry has priority over shapes in the motion clip.
Use @video1 for motion only: match the jump, turn, and landing timing. The performer is the character in @image1. Setting: bright dance studio with mirrors. Camera: locked wide. Audio: silent. Constraints: clean hand and foot contact, outfit from @image1.
Use @video1 as the shot plan: keep its camera path, shot order, and positions. Replace the gray placeholder set with the environment in @image1 and the placeholder figure with the character in @image2. Constraints: do not inherit gray materials or block shapes from the previs.
Spunti con dialoghi e audio
- Subject
- a barista in a plain black apron behind a bright counter
- Action
- she hands a cup toward the camera and says, "Single origin, no sugar, exactly how you like it," then nods
- Camera
- locked medium close-up
- Audio
- natural speech, light cafe ambience under the line
- Constraints
- one line only, no text, no logos
- Subject
- two friends on a school gym floor
- Action
- one whispers, "Don't tell anyone, but I got in," and the other covers her mouth in surprise
- Camera
- static two-shot at eye level
- Audio
- whisper with a soft room echo
- Constraints
- faces and clothing consistent, no extras
- Subject
- an elderly fisherman on a wooden pier
- Action
- he reads a message on an old phone, lowers it, and looks out at the gray sea
- Camera
- slow side push-in
- Audio
- gulls and water only, no dialogue, no music
- Constraints
- weathered face consistent, overcast light steady
- Subject
- a couple in a small kitchen with a burned pan
- Action
- she says, "That was the last one," he replies, "It was already old," and both laugh
- Camera
- medium two-shot, slight handheld
- Audio
- overlapping laughter, no music
- Constraints
- one continuous take, warm evening light
Errori comuni nei prompt
| Errore | Cosa diventa di solito difficile da valutare | Revisione migliore |
|---|---|---|
| Troppi obiettivi | La clip non ne realizza chiaramente nessuno | Tieni una sola promessa visiva e una sola risoluzione |
| Indicazioni in conflitto | Movimento di camera e del soggetto si fanno concorrenza | Scegli un solo movimento di camera principale |
| Azione vaga | Il modello riempie il tempo con movimenti generici | Usa verbi visibili e indica chi compie l'azione |
| Nessun finale | La clip si interrompe a movimento in corso | Riserva l'ultimo momento a un'inquadratura ferma o a un richiamo |
| Riferimenti senza ruolo | Stile, identità e sfondo passano da un asset all'altro | Dai a ogni asset un ruolo esplicito |
| Elenco di divieti troppo fitto | I vincoli importanti si perdono in un muro di proibizioni | Tieni un elenco breve di dettagli fissi verificabili |
| Due soggetti alla pari | Il modello ne sceglie uno e l'altro deriva o sparisce | Indica un soggetto principale e dai al secondo una reazione |
| Momenti che si sovrappongono | Due azioni si contendono gli stessi secondi | Dai a ogni momento il suo intervallo e una sola azione |
| Parole di stile contraddittorie | "Documentary" più "anime" più "cinematic" si annullano | Tieni una sola famiglia di stile per prompt |
Perché Seedance 2.5 ignora parte di un prompt
Quando un risultato salta un'istruzione, la causa di solito è una di tre cose nel prompt stesso, non un controllo mancante:
- Soggetti in competizione. "A barista and a customer talk while a dog runs past" dà lo stesso peso a tre protagonisti. Riscrivilo con un soggetto principale: "A barista pours a latte and looks up; a customer in the doorway reacts. No other people or animals."
- Istruzioni sepolte dopo la prima frase. I dettagli che compaiono tardi in un paragrafo lungo sono i primi a cadere. Sposta il vincolo irrinunciabile (l'etichetta resta leggibile, il volto resta lo stesso) su una riga breve a parte.
- Modalità sbagliata. Chiedere a un prompt da testo a video di "keep the product exactly like the photo" non può funzionare senza la foto. Passa alla modalità da immagine o con riferimenti e assegna un ruolo all'asset, invece di descriverlo con più insistenza.
Correggi il prompt, rigenera una volta e confronta gli stessi secondi nelle due clip prima di cambiare altro.
Non inventare controlli che non esistono. Se l'interfaccia attuale non offre un prompt negativo, un cursore per il controllo della camera o un comando di editing locale, non scriverlo come se fosse disponibile. Inserisci i vincoli necessari nel normale linguaggio del prompt e verifica le impostazioni visibili sulla piattaforma che usi.
Flusso di revisione a una variabile
- Salva il prompt e i riferimenti usati per la versione di base.
- Guarda il video completo una volta senza modificare il prompt.
- Individua il problema più grande: soggetto, movimento, camera, timing, audio o finale.
- Cambia solo il campo responsabile di quel problema.
- Genera di nuovo lasciando invariati gli altri campi.
- Confronta le due clip negli stessi momenti, soprattutto il primo e l'ultimo fotogramma.
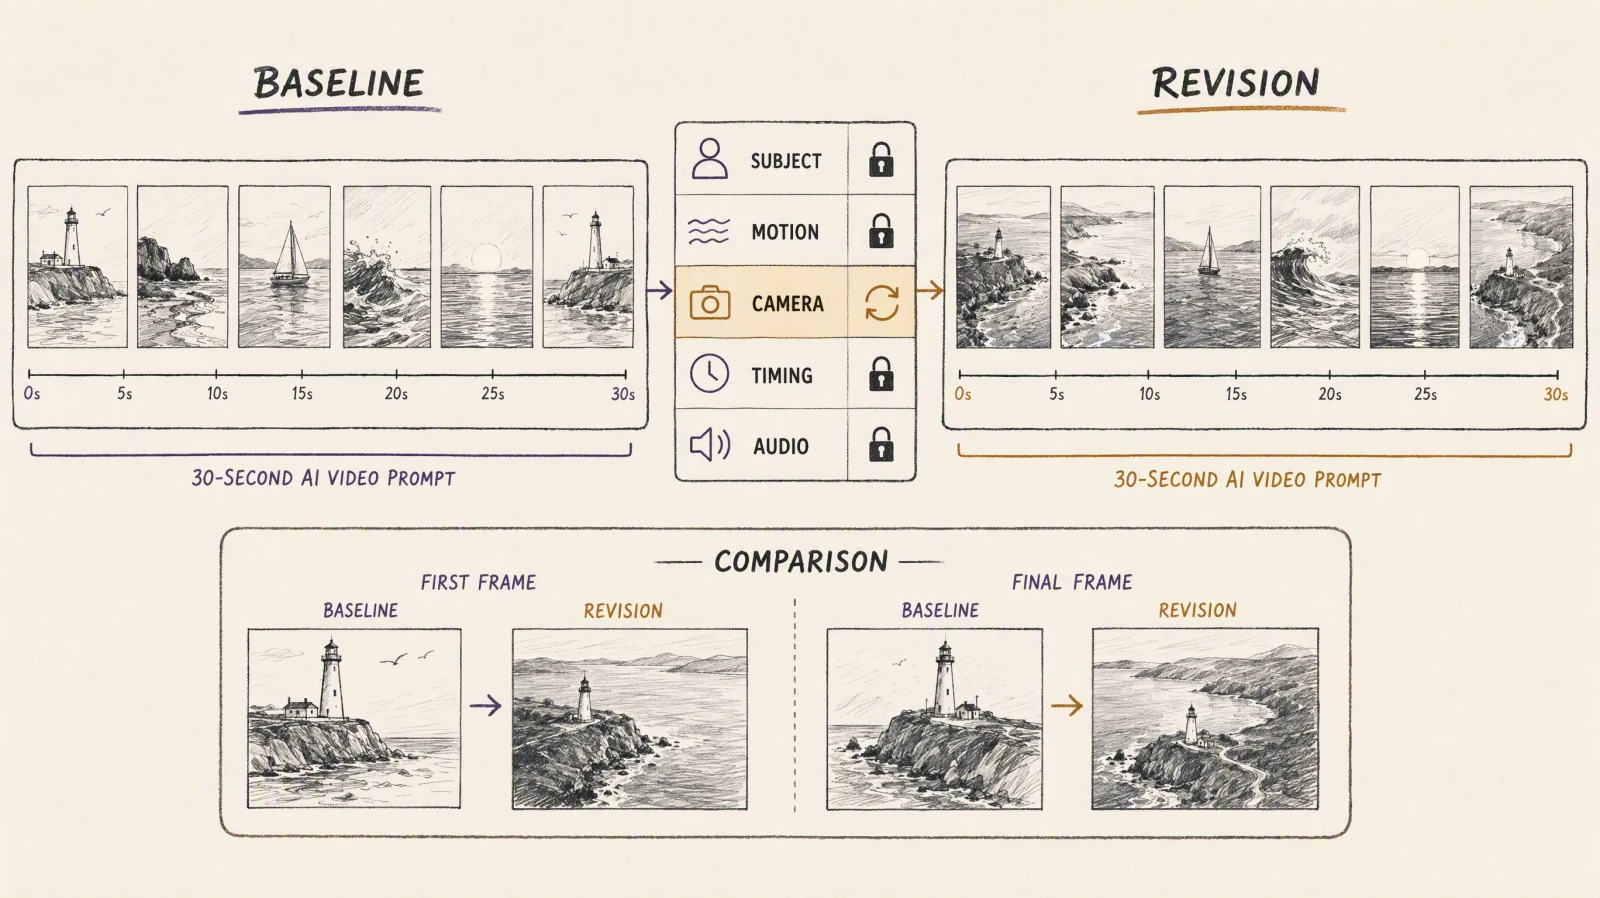
Una revisione a una variabile rende più facile capire quale modifica al prompt ha aiutato.
Se il prodotto cambia forma, rafforza il ruolo del riferimento di identità o di prodotto prima di toccare il linguaggio della camera. Se la parte centrale si trascina, rivedi il timing prima di aggiungere altra azione. Se il dialogo sembra affrettato, accorcia le battute o aggiungi indicazioni di pausa invece di cambiare lo stile visivo.
Prima e dopo: tre revisioni di una riga
Tre dei render di prova avevano un errore evidente, quindi abbiamo cambiato una riga di ciascun prompt e rigenerato con gli stessi input e le stesse impostazioni. Tutto il resto del prompt è rimasto parola per parola.
| Esempio | Problema al primo passaggio | Riga modificata | Risultato al secondo passaggio |
|---|---|---|---|
| 3 | Manca l'apertura sulla ciotola finita; deriva di colore | Timing, riscritta per 4 secondi | Apertura, colore e finale corretti; il salto in padella è diventato una colata di salsa |
| 7 | Due contenitori alla fine | Constraints: "exactly one container" | Finale corretto; ancora due contenitori, perché il riferimento ne mostra due |
| 8 | Personaggi A e B scambiati | Action: ogni personaggio legato a un outfit | Blocking corretto; un accessorio è finito sul personaggio sbagliato |
Revisione 1: esempio 3, riscrivi Timing per la durata reale
Il primo render si apriva sugli ingredienti crudi e finiva con noodles arancioni. La seconda versione ha sostituito solo la riga Timing:
Timing: 0-1s finished bowl from overhead; 1-3s one toss of the noodles; 3-4s lifted bite over the same finished bowl.
Ora la clip si apre sulla ciotola finita, i colori restano stabili e l'ultimo fotogramma solleva un boccone sopra la stessa ciotola. Sono comparsi nuovi errori: il salto in padella è diventato una colata di salsa, l'inquadratura dall'alto è diventata un'angolazione di circa 45 gradi e le bacchette sono diventate una forchetta. Ecco la versione completa da 4 secondi, pronta da testare:
- Subject
- a home cook making a bright citrus noodle bowl in a clean kitchen, using generic unbranded ingredients
- Action
- open on the finished bowl, rewind the visual idea into preparation, toss the noodles, then return to the finished bowl with steam and a lifted bite
- Camera
- overhead hook, two fast close inserts for zest and sauce, medium side shot for the toss, locked close-up for the ending
- Timing
- 0–1sfinished bowl from overhead
- 1–3sone toss of the noodles
- 3–4slifted bite over the same finished bowl
- Audio
- crisp kitchen sounds with a light rhythmic pulse, no spoken recipe and no generated captions
- Reference roles
- none
- Constraints
- one bowl, stable ingredient colors, safe utensil handling, no labels, no impossible food transformations
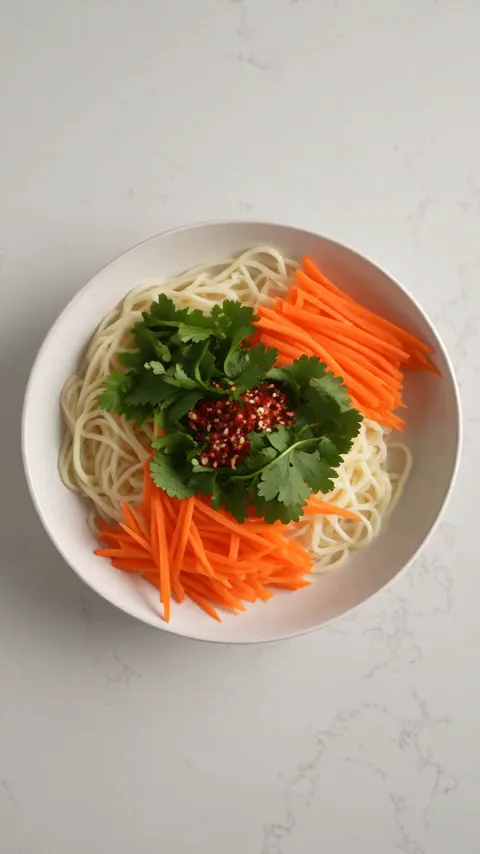
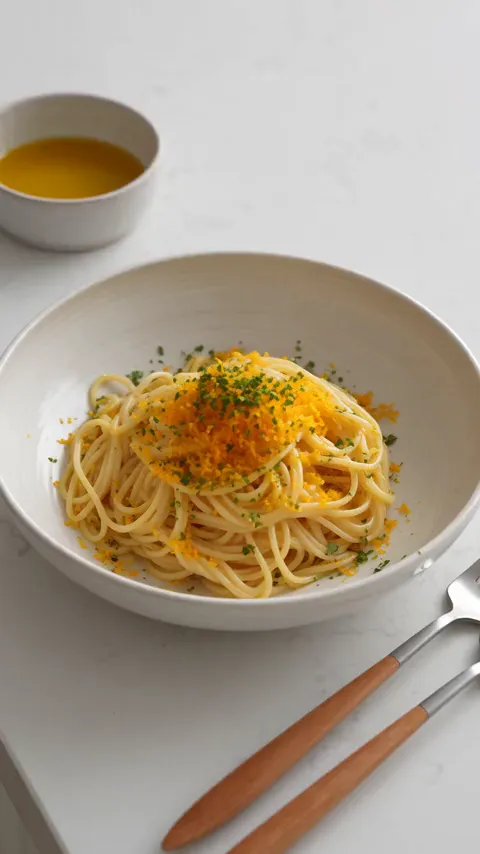
Esempio 3, entrambi i render da 4 secondi (in loop). A sinistra: la riga Timing da 30 secondi. A destra: la riga Timing da 4 secondi.
Revisione 2: esempio 7, correggi il riferimento, non il vincolo
Il primo render finiva con un secondo contenitore, piegato, accanto a quello pieno. La seconda versione ha aggiunto una sola clausola all'inizio della riga Constraints:
Constraints: exactly one container in every shot, the one from @image2;
Il finale è migliorato: la clip è tornata sul presentatore in mezzo primo piano, cosa che il primo render non aveva mai fatto. Ma il presentatore tiene ancora due contenitori, uno pieno e uno piegato. La causa sta in @image2. La nostra foto prodotto sostitutiva mostra due contenitori, uno aperto e uno piegato, quindi il modello ha considerato i due contenitori parte del prodotto. Una frase nel prompt non poteva avere la meglio sull'immagine. Se il riferimento del prodotto mostra due oggetti, ritaglialo o rifai la foto in modo che ne mostri esattamente uno prima di aggiungere vincoli.
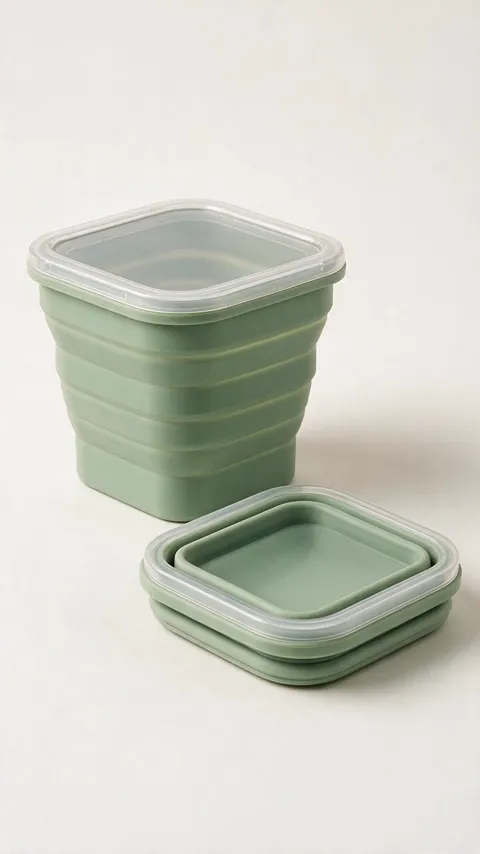
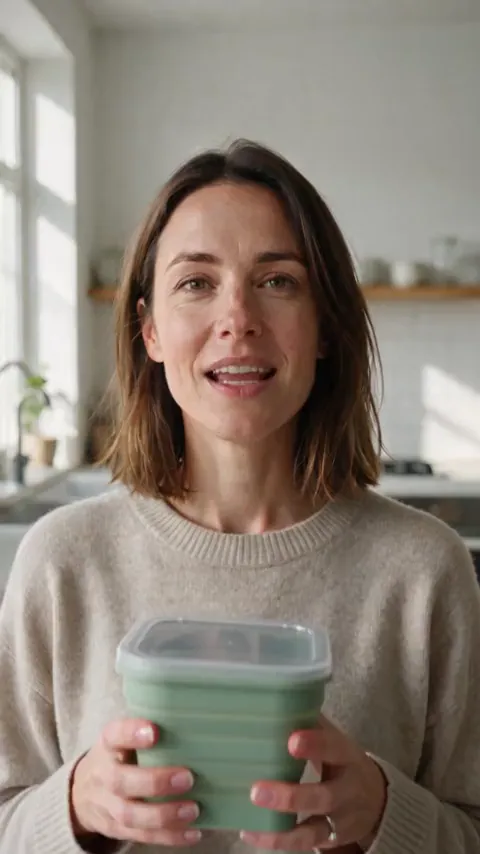
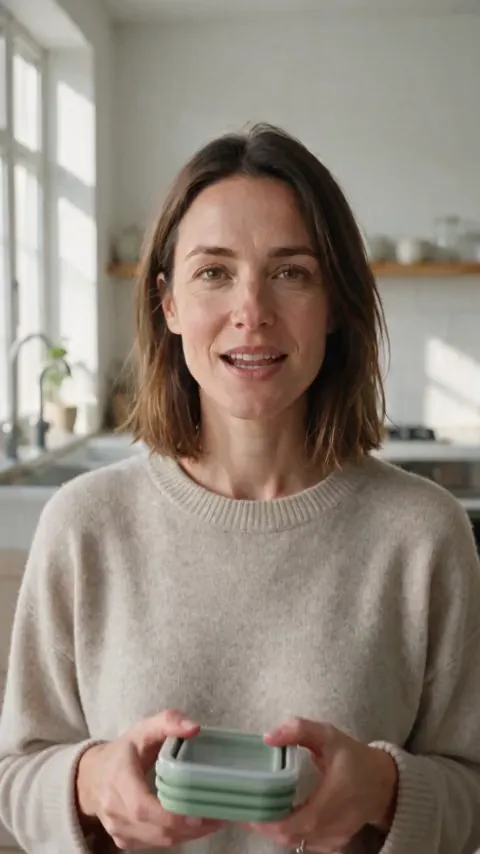
Esempio 7: il riferimento del prodotto (a sinistra), il primo render (al centro) e la revisione (a destra), entrambe clip da 4 secondi in loop e senza audio. Entrambi i render copiano i due contenitori del riferimento.
Revisione 3: esempio 8, lega ogni personaggio a un outfit
Nel primo render il personaggio con la sopracamicia senape andava alla finestra, il compito che il prompt assegnava ad A. La seconda versione ha riscritto la riga Action in modo che ogni personaggio sia legato a un outfit preciso della tavola dei costumi:
Action: character A, wearing outfit A from @image2 (charcoal sweater), crosses to the window; character B, wearing outfit B from @image2 (mustard overshirt), waits by the table; then both react to a light outside.
Ora il blocking è corretto: A in antracite va alla finestra e B in senape resta vicino al tavolo. La correzione ha fatto emergere una nuova fuga: il berretto che sulla tavola appartiene all'outfit A è finito su B. Il carrello laterale e la reazione condivisa mancano ancora. Quando una tavola dei costumi include accessori, assegnali per nome a ciascun personaggio oppure toglili dalla tavola.
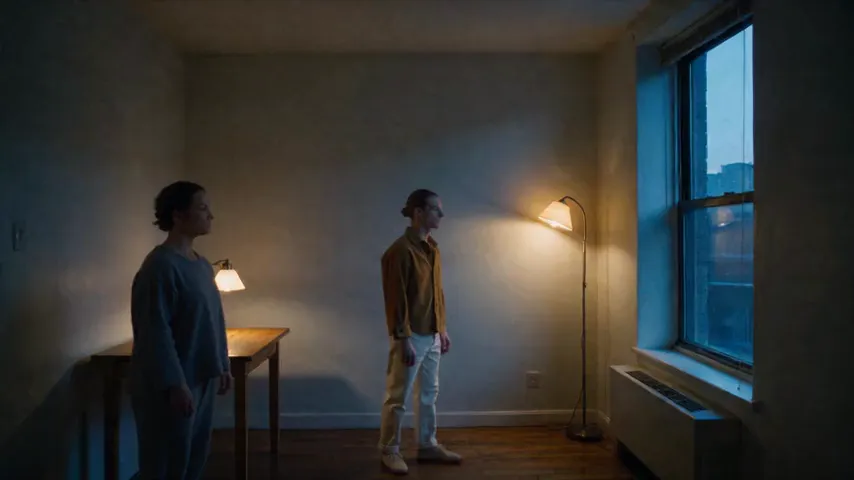
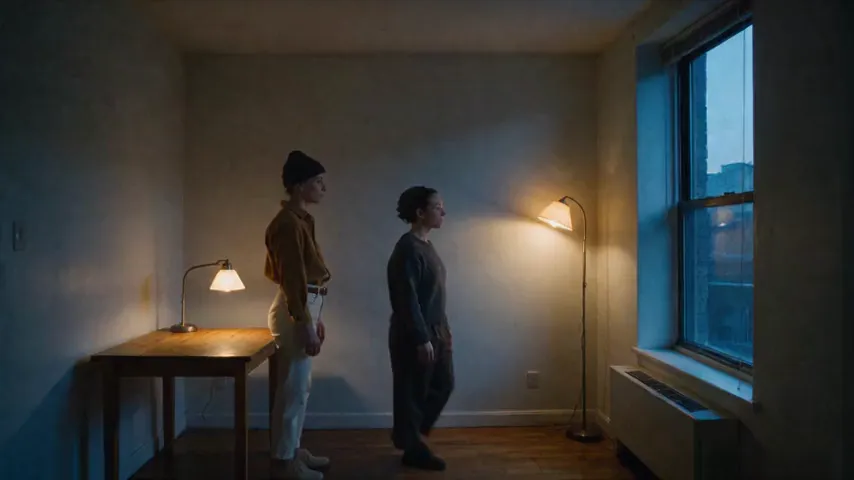
Esempio 8, entrambi i render da 4 secondi (in loop). Sopra: la riga Action originale. Sotto: personaggi legati agli outfit.
Le tre revisioni vanno nella stessa direzione. Una riga Timing scritta per la durata reale e una riga Action che dice chi indossa cosa hanno corretto entrambe ciò a cui miravano. Un vincolo che contraddice l'immagine di riferimento no. Quando un risultato continua a copiare qualcosa di sbagliato, controlla cosa mostra davvero il riferimento prima di scrivere altre regole.
Note su diritti e sicurezza
Usa prompt, immagini, video, audio, sembianze, voci e asset di marca che possiedi o che hai il permesso di usare. Il consenso per un ritratto non include automaticamente la clonazione della voce o la pubblicità commerciale. Un video di riferimento può contenere anche musica, opere d'arte, loghi o persone i cui diritti vanno verificati a parte.
Mantieni i modelli generici finché gli asset approvati non sono pronti. Non usare un personaggio pubblico, un personaggio di finzione, una scena di film riconoscibile o il logo di un concorrente come scorciatoia per stile o identità. Prima della pubblicazione controlla ogni output alla ricerca di etichette alterate, affermazioni inventate, persone non previste e azioni non sicure.
FAQ
Quanto deve essere lungo un prompt per Seedance 2.5?
Abbastanza lungo da definire i sette campi, abbastanza breve da poter verificare ogni istruzione. Un brief compatto e strutturato è di solito più facile da rivedere di un paragrafo fitto. Togli gli aggettivi che non cambiano una decisione visibile.
Quante inquadrature deve includere un prompt da 30 secondi?
Parti da due a quattro momenti leggibili. Si possono fare più stacchi, ma ogni inquadratura in più aggiunge lavoro di continuità. Può funzionare anche un'unica ripresa continua, quando l'azione del soggetto cambia chiaramente nel tempo.
Posso usare @image1, @video1 e @audio1?
La documentazione dei modelli di SeedVideo AI supportava questi marcatori basati sull'ordine dell'array alla verifica del 2 agosto 2026. Usali solo in un flusso che oggi supporta i marcatori dei riferimenti. Dreamina e altri prodotti possono etichettare gli asset in modo diverso.
Devo scrivere un prompt negativo?
Solo se l'interfaccia attuale offre un campo documentato per il prompt negativo. Altrimenti aggiungi una breve sezione Constraints al prompt principale. Non dare per scontato che esista un controllo separato.
Come si scrive il prompt per l'audio?
Indica se la clip ha bisogno di dialoghi, ambiente sonoro, musica, effetti sonori o silenzio. Descrivi il rapporto temporale generale, per esempio una pausa prima della rivelazione. Usa audio con diritti verificati ed evita di chiedere la voce di una persona che non l'ha approvato.
Come mantengo coerente un personaggio?
Usa un solo riferimento di identità approvato, ripeti i dettagli stabili di abiti e ambientazione e limita i cambi di scena evitabili. Controlla volto, capelli, abiti, proporzioni del corpo e linee di sguardo lungo tutta la clip.
Cosa devo cambiare dopo una generazione non riuscita?
Cambia il campo legato al problema visibile più grande. Rendi più precisa l'azione quando il movimento è vago, semplifica la direzione della camera quando l'inquadratura deriva e rivedi il timing quando manca il finale. Lascia fissi gli altri campi per il confronto successivo.
Perché Seedance 2.5 ignora parte del mio prompt?
Di solito perché due soggetti o due azioni si contendono gli stessi secondi, perché un vincolo chiave sta alla fine di un paragrafo lungo, o perché il prompt chiede alla modalità testo di preservare qualcosa che solo un'immagine o un asset di riferimento possono trasmettere. Vedi la checklist sull'aderenza nella sezione Errori comuni nei prompt.
Posso testare prima a 4 secondi un prompt Seedance 2.5 da 30 secondi?
Sì, ma prima riscrivi la riga Timing per 4 secondi. Nei nostri 12 render di prova a 4 secondi e 480p, i prompt che mantenevano la riga Timing da 30 secondi mostravano per lo più il primo o i primi due momenti e saltavano il finale. Con una riga Timing da 4 secondi, l'esempio della ricetta ha mostrato sia l'apertura sia il finale.
Gli intervalli di timing sono comandi precisi al fotogramma?
No. Sono una struttura di pianificazione, a meno che il prodotto attuale non documenti esplicitamente un controllo del timing più preciso. Controlla il risultato invece di dare per scontato che ogni transizione cada su un secondo esatto.
Fonti e metodologia
-
Dreamina Seedance 2.5 prompt guide, verificata il 2 agosto 2026, per i suoi esempi pubblici di pianificazione a 30 secondi e di prompt con riferimenti.
-
Pagina del modello Seedance 2.5 su Dreamina, verificata il 2 agosto 2026, per la descrizione pubblica della generazione a 30 secondi e dei flussi con riferimenti multimodali.
-
Pagina Seedance 2.5 di SeedVideo AI, verificata il 2 agosto 2026, per la scheda del modello, le modalità di input e le indicazioni attuali sul prodotto.
-
Documentazione dei modelli di SeedVideo AI, verificata il 2 agosto 2026, per i limiti attuali dei riferimenti, la scelta della modalità e la sintassi
@image1,@video1e@audio1. -
Pagina del modello Seedance 2.5 di SeedVideo AI e generatore web con accesso effettuato, verificati l'11 ottobre 2026, per durata delle clip, risoluzioni, modalità bozza, limiti degli input di riferimento e tariffe in crediti nel riepilogo rapido delle impostazioni.
-
Render di prova di prima mano, 13 ottobre 2026: tutti i 12 esempi completi generati una volta su Seedance 2.5 a 480p e 4 secondi, più le revisioni di una riga degli esempi 3, 7 e 8 con gli stessi input e le stesse impostazioni. Gli input erano immagini e clip di movimento sostitutive generate con l'AI, voci sintetiche text-to-speech e un loop musicale sintetizzato originale. Le note descrivono solo l'immagine.
Tutti i 12 esempi di prompt di questa guida sono modelli originali da riscrivere. Non sono raccomandazioni ufficiali del modello e non garantiscono un risultato particolare.
Costruisci il tuo prompt per Seedance 2.5
Apri Seedance 2.5 su SeedVideo AI, scegli la modalità adatta ai tuoi input e parti da un modello. Sostituisci ogni segnaposto con materiale approvato, genera una versione di base, poi rivedi un campo alla volta. I modelli sono testo semplice, quindi funzionano senza modifiche anche in altri studi che usano il modello, come Seedance 2.5 su Yovid.